|
|
|
机器之心报道
@8 e# s- F8 P9 Z5 X& J. }3 W9 p参与:杜伟、张倩前几天,OpenAI 发布了 7.74 亿参数量的新一版 GPT-2,并表示将在几个月之内发布 15.58 亿参数量的完整版本。但还没等到完整版官宣,有人就已经等不及了,索性自己动手复制了一个 15 亿参数量的 GPT-2,并将其命名为 OpenGPT-2。项目作者是来自布朗大学的两位硕士研究生,他们复制 GPT-2 的花费大约是 5 万美元。
' R7 o1 c7 h$ Y7 S* N/ Q6 z' d! F6 J6 N- J3 t! p! U- F
项目的两位作者:Aaron Gokaslan 和 Vanya Cohen 。
! P" h% ]" e8 F, n4 D读者可以在 Google Colab 上访问该模型并生成文本。4 e2 _7 W7 ?5 J
Google Colab 地址:https://colab.research.google.com/drive/1esbpDOorf7DQJV8GXWON24c-EQrSKOit
# N1 y' V3 u2 W2 q. V1 v( D, a
3 P. K$ _) \* S/ R模型权重:https://drive.google.com/drive/u/0/folders/1KfK5MXtvgH8C615UUZoKPIUVJYIdJxX1
2 B# p% Q- n- j1 w6 J8 Q8 K3 {作者表示,复制 GPT-2 没有那么难,论文中的很多结果都是他们两人可以复制的,并且二人并没有语言建模的经验。所以,只要你感兴趣(壕),你也能自己复制一份。( ^& [7 j' `9 ^! V9 n* V
: }; ]& N& A$ |) n# B
/ d' E4 t, I7 k! x8 I5 W$ o0 C复制方法和成本3 l, F& c0 U: l, H- K8 V$ v
0 c) @3 O/ S0 h$ [
OpenGPT-2 的实现基于 Grover 模型,通过修改它们的代码库来达到 GPT-2 的语言建模训练目标。由于 Grover 模型是在类似的大型语料库上进行训练,所以很多代码和超参数很容易重复使用。他们也没有对 Grover 的超参数进行大量修改。4 }7 V, m3 w) M. n$ |3 |( |2 Z5 R
$ @$ w( y8 W' F至于成本嘛,他们使用自己的代码从零开始训练 GPT-2 模型大约花费了 5 万美元。但需要注意的是,5 万美元只是云计算的估算成本,没有包含更细微的内在成本(在其他效率更低的易用计算资源上训练模型的效果会更差)。7 U9 i, @, x3 B9 a5 M, W( l
; @0 A f* e. x
数据集3 C. q3 j \* n
`$ U4 c% `+ rOpenAI GPT-2 的原始论文中有对清理数据集的详解。在该论文中,Open AI 的研究人员用到了一个名为 WebText 的数据集,其中包含数百万个网页。+ ?$ _8 z: x- t* A* V$ h( ?, V
% L5 F* [5 e- o; R+ n4 e论文地址:https://d4mucfpksywv.cloudfront.net/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
* a9 o2 f o" D) C, e1 w1 H5 g
* Z$ J. X* L1 W7 V( z如 WebText 一样,本文中的两位研究者首先解析 Reddit 上 3 个 up-vote 以上的所有链接。同时,他们利用了 Pushshift Reddit scrape 数据集,该数据集集合了持续更新的 Reddit 帖子、评论和有关元数据。然后,作者对这些链接进行过滤,删除那些不太可能包含有用文本或 HTML 的文件类型(即视频文件、PDF 和 CSS 格式文件)的直接链接。
2 D2 M$ l- v2 `+ `' |
) q8 J! G" s8 A& n% X此外,作者还过滤了网页,以删除被各种评估基准和数据集所使用的 Wikipedia 内容。他们并不能确定自己的过滤方法是否符合 OpenAI 的标准。因此,他们使用 Newspaper Python 库从 HTML 网页上提取文本,然后使用 fastText Python 库只过滤掉英文文本。* |0 T+ D2 _1 v: ^
9 u0 T O! Q- f$ c
具体来说,作者使用了 WhatTheLang python Wrapper。他们利用局部敏感哈希(locally sensitive hashing,LSH)删除这些文档。最后,他们将这些文档散列到了 5-gram 的集合中,并删除了相似度阈值大于 0.5 的所有文档。' U; b; W' i1 |
# G. L9 f: U+ c* W9 `; u2 n作者还从数据集中删除了 token 数少于 128 的文档。这些短文档往往质量较低。作者将这一数据集作为 OpenWebTextCorpus 发布。' U5 N5 n. q6 z( v1 d# \
0 K& F+ [8 `7 r& n4 _. e0 J7 D数据集链接:https://skylion007.github.io/OpenWebTextCorpus/1 g! l& P7 @( C
, m+ r; G; x' `, Z# ?
在编码数据集时,作者使用了 Radford 等人发布的适用于小模型的 Binary Pattern 编码器。他们还利用 OpenWebText 网页爬取代码库的修订版作为自身数据集集合的起始点。
; M8 K: Q2 @- o% Q, {& i# ]# V/ k. F. a# J0 r, J& X
从公开发布的 WebText 的 26 万篇文档的集合来看,作者发现所有文档的双字节编码(BPE)长度最小为 40,最大为 1024。而 OpenWebText 的不同之处在于作者将文档长度的最低值设为 128 个 token(替代 BPE),并且不限制文档最大长度。此外,原始 WebTextCorpus 是在这些样本可用之前发布的,因此作者没有使用这些信息来生成清理启发式。
$ T' Q3 I* |% K6 S' u9 y7 q4 }* q! L# n
尽管在训练分布上存在差异,作者依然得出了与多数数据集接近的困惑度。/ A2 o% c0 g! g5 \% e, K% @
" E a; U( D% x, v8 f
3 F) y# }3 e. m) ~效果
5 `: H1 T; C$ }- j/ d7 P; M2 x- C2 U, B! m8 ^ w! D2 @
两位作者在 medium 博客中展示了 OpenGPT-2 的生成效果。他们提供给模型的提示为:「Recycling is good for the world. NO! YOU COULD NOT BE MORE WRONG!!」,输入模型之后得到了以下输出:
# W/ \7 w/ v% ~) o
) ]$ y1 T! l- v$ L Q, B$ L u+ d' s- z4 D: j+ Q0 B
! w8 u( @9 L! K& I; o6 O+ e& T
reddit 网友也根据作者给出的连接进行了测试,并将测试结果与 OpenAI 前几天公布的 7.74 亿参数量版本进行了对比。有人表示:" D$ a2 A3 ?3 T6 V8 S
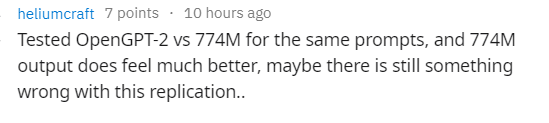 我使用相同的提示分别测试了 OpenGPT-2 和 OpenAI 的 GPT-2 7.74 亿参数版本,结果还是 OpenAI 的输出效果更好,所以作者的复制过程或许存在一些问题。 : ?/ d9 C- f [" c
, i* C) ^ \* L' k" \ R当然,也有人认为 OpenGPT-2 的效果更好:+ {( Q/ o {' n% B; h( n$ G. ~# p
7 b; R4 H: L3 I0 P) W' u
3 B* b/ B, r+ _0 J8 V8 a我认为作者的 OpenGPT-2 效果优于 OpenAI 的 GPT-2 7.74 亿参数版本,但还不足以用来制造令人信服的假新闻。几次尝试输入「Shocking revelation! Vladimir Putin and Donald Trump are」,我得出了以下效果最佳的文本。该文本能够更长时间地保持语义连贯性,语句也更有意义,但还是比较容易被识破。但不可否认,OpenGPT-2 对研究确实很有帮助。2 V3 Q+ p+ @% j* {
/ b" P) N- o, r8 R4 H6 K但我还有一个疑问,OpenGPT-2 到底只是把它读过的文本随机组合到一起,还是真正地创造出了新文本。 5 F$ p7 m* h p- u: [3 v
+ d4 ?# q+ Y, P" V* q
2 E$ e) o- x, W$ n. w# F' S% u8 f0 i
至于 OpenGPT-2 的生成效果究竟如何,大家可以根据文中提供的链接测试一下。# u" P$ E5 W! I/ o: X3 y! S7 H# l, ^
: y' b3 J' o# c; o E6 U7 n: z' J参考链接:7 w/ |1 I+ O0 p
( ~0 F) f( I% L6 y+ i7 a" [& J7 V6 ]" ^% e1 g
+ T' v9 N9 E* C& T. p
https://www.reddit.com/r/MachineLearning/comments/cu9xgi/p_opengpt2_we_replicated_gpt2_because_you_can_too/! F' a1 w$ h4 X/ \: `6 e' b- j
https://medium.com/@vanya_cohen/opengpt-2-we-replicated-gpt-2-because-you-can-too-45e34e6d36dc: F/ Y; F6 u8 I/ p( x: K
& m' u" h o. h# B4 D3 I+ W
/ B H: h: N; e: r: T; d# F
7 `. v$ V) ~9 _; Q! A% W1 U
WAIC 2019 开发者日 将于 8 月 31 日在上海世博中心举办,包含 1 个主单元、4 个分单元、黑客马拉松比赛和开发者诊所互动区。
, N6 l+ U6 `. G4 ~
届时,全球顶尖 AI 专家、技术大牛、知名企业代表以及数千名开发者将齐聚上海,围绕人工智能前沿理论技术和开发实践进行分享与解读。 ; ~: ]' X" S3 O3 {
点击阅读原文,立即报名。 . C4 h0 j+ U$ E: }
0 P0 _. @9 T1 {3 q
- v$ s# q ]. z& ]7 z" V, V来源:http://mp.weixin.qq.com/s?src=11×tamp=1566630003&ver=1809&signature=lixpkgck3Jci-PJs9nuYQ2-e-AoYyRsK9T2JfY8UTHbrfqeLiSdjvkGmvntU-OVvGe8*llf7XPaBdBKSdmrL7CrALKS1LX-KQs*HOTH8twOu5W3TN*s6mdYxiqgYsckc&new=1
6 q) i) Q4 L/ Z$ E9 N, m" @" \6 `免责声明:如果侵犯了您的权益,请联系站长,我们会及时删除侵权内容,谢谢合作! |
本帖子中包含更多资源
您需要 登录 才可以下载或查看,没有账号?立即注册

×
|
 |手机版|小黑屋|梦想之都-俊月星空
( 粤ICP备18056059号 )|网站地图


 发表于 2019-8-24 15:03:59
