0x01 HIDS的背景
; Q/ x& i$ B' H7 p
( G7 Y$ F4 b2 W- A企业有各种安全防护手段,HIDS与网络流量监听一样, 是一种威胁检测的手段。HIDS(Host-based Intrusion Detection System)基于主机型入侵检测系统。与网络监听这种形式的主要区别是, HIDS的主要数据源来至于主机本身产生的各种审计信息。
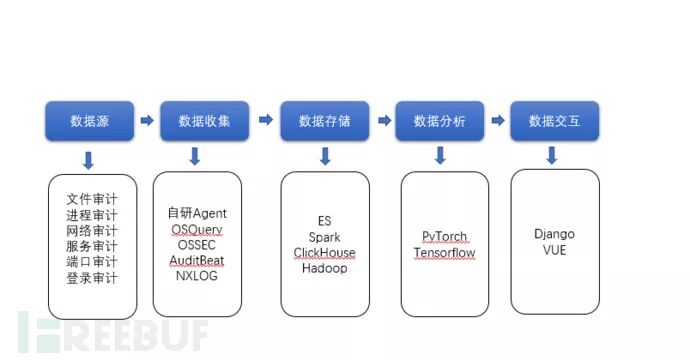
, C2 Z" z. X; ?. s' F1 M各公司在构架这样的系统时, 多多少少都会面临时相同的问题,其中有一个共通地方就是审计数据的存储方案如何建设,我们回顾了一下,讨论一下HIDS的数据处理流程,与相应存储方案的优劣。# h/ d& [2 p L1 m$ E. k3 F3 a/ A
 0 h/ T4 d$ G( s, X/ `
0x02 HIDS与网络监听: z7 Q. a! f; O0 l( A. O
& L; {1 ?' E$ V ?( p0 X通过在主机上安装一个审计数据收集的 agent代理程序,收集主机的相关信息。
: ]; |5 q/ o# ^* W3 V7 o oHIDS系统和其他的系统都很多的相似之处,也有着明显的区别。Agent安装收集数据,与网络分光流量监听对比最大的区别,在于要在机器上装Agent,这本身是成本(部署覆盖率,监控覆盖率),而网络分光只要将数据集中,就可以分析流量中的网络相关数据。9 j# T3 v; Z7 M2 v; {- e5 g
实际上Agent上收集的数据总量,几乎占到一半存储比例的还是网络数据, 比如:网络连接数据(异常链接、网络等待等)。
8 N( _4 l- s! j% }某种程度HIDS与网络流量监听, 即互补又殊途同归。
7 |. N2 u+ e6 Z说到相同的地方, HIDS与其他的安全信息系统,有很多信息本身应该具备的组织部分,比如数据的存储,数据的分析,让安全运维人员与整个系统交互,进行安全策略的地方。
; e2 l. c) S$ R各大公司都有自己系统设计方案和建模方法, 他们用的审计数据源种类也许是相似的,大数据的存储方案也差不多, 建模的方法也是经典的建模方式,甚至有可能“攻击者”都是同一波人。
% k4 a4 W z- [$ t8 c3 y; ?基于类似的背景,才可能将整个方案通用化, 产品化。没有形成产品,也可以制定一个通用的模型框架。$ u: R( D& S8 V8 r
0x03 数据处理流程
& L& F+ l& R) D" _0 t/ O
e+ T" N0 w1 e# p- l) c我们将整个系统分成几个模块,来看整个系统:
0 r3 m' }* }; G, V. D+ u9 Y9 f* M数据源:主机服务器上有各种审计数据,这些审计的数据是整个系统的数据分析素材。账号信息、网络链接、登录信息、服务信息、处理器信息等。无论什么平台, 这些基本的审计信息几乎都是共有的。$ Y1 j: W1 O7 D6 b6 Z+ l! p
我们用OSQuery举例,用开源方案说明问题, 可以脱敏。9 R7 L9 r' D: r/ ]5 C
比如,取得当前主机的端口监听:/ d: k& t: t; s* H! a
! e! j3 K7 T0 w) o. H( H- " J6 @5 e) x1 Q* R: @
osquery>select * from listening_ports pid | port| protocol|family | address 123| 808| 0 | 0 | 0.0.0.0市面上流通的入侵检测代理客户端(跨平台),很多是可以取得这些信息的。OSQuery是将主机各种类型的Audit信息,统一管理成了二维表(Virtual Table),提供了一个SQL查询引擎提供查询。
0 g) ^( d; v) W t2 w% w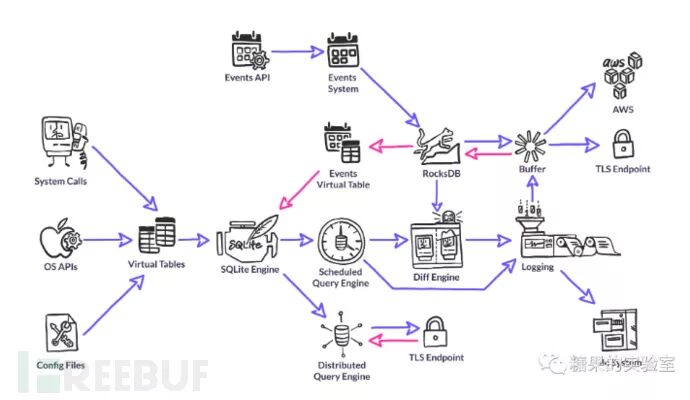 ) |* n+ J* ~( p1 \1 M
OSQuery架构图
4 ^( n9 V# L! b5 K0 L0 }( w$ e数据收集:面对各种主机审计数据源,系统必须要有一个数据收集能力。
% l% T3 I4 ^8 g, DHIDS一个很重要的组成部分是Agent, 不只是安全系统才有Agent,像Zabbix这种监控服务也同样用Agent。数据收集Agent方法有几种方法选择:1.自行研发。2.开源方案。 2 x) [+ p$ l, q, S
相同的目的:无论我们使用的开源方案,还是自研的Agent,目的都是一样的, 收集我们需要数据,服务器上的相关审计信息。只要能收集到我们想到的审计信息上这一点没有障碍,就达成目标。
6 R' }8 z- |& `2 t; o2 `. M无论我们是采用开源,还是自研的方案,系统底层的很多都是相通的。以Linux的系统为例子看下图。
4 [$ `) x8 u+ S* ~# M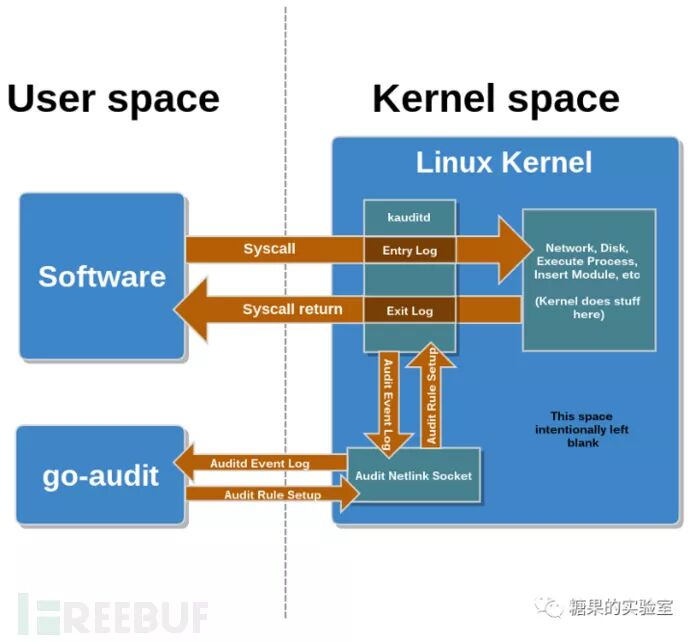 $ H6 j K6 A2 K+ Z3 x* O
OSQuery或是自研的Agent相当于图中的go-audit, 都是系统审计日志Client客户端调用者。使用pythonaudit和caudit底层调用的API都是系统API,区别是对各种平台的支持(跨平台),Agent的性能和健壮性。" f8 P9 B8 I. o( A* f: S
[color=#777575 !important]自研Agent优点:对于自研agent来说,我们可以控制整个软件的逻辑, 尽情的加入我们想扩展的功能。3 _% d( P. K: J- u9 G5 J9 r5 n5 C
[color=#777575 !important]自研Agent劣势:需要大量的平台适配,保证测试的覆盖率,不能轻易挂,没有社区的服务支持。
6 A% ]. {, r: @: y[color=#777575 !important]开源Agent优势:对于开源agent来说,开源Agent被行业充分的测试, 可以稳定的在企业各种已知的平台上,收集不同平台的数据,Linux、Windows、MAC。自研的方案各大厂都有自己的轮子。开源Agent方案:AuditBeat、OSQuery、NxLog等等,可以根据规模和平台的大小进行选择,各种入侵检测方案。. `- e5 {/ Q( w& e! s4 |+ I
[color=#777575 !important]开源Agent劣势:需求的定制化和扩展性, 是否能适应企业审计需求,数据采集需求,后续是否会出现,软件停止维护等尴尬局面。 D9 k. O! M. M$ q) `7 }9 L2 j
HIDS的Agent收集的数据,之前说过,占比最大的一块数据是网络相关数据(几乎总量50%),随着时间的推移,工具的进来,“Netstat”相关信息取得也发生了变化。
0 e8 e. z$ g& {, O' R. S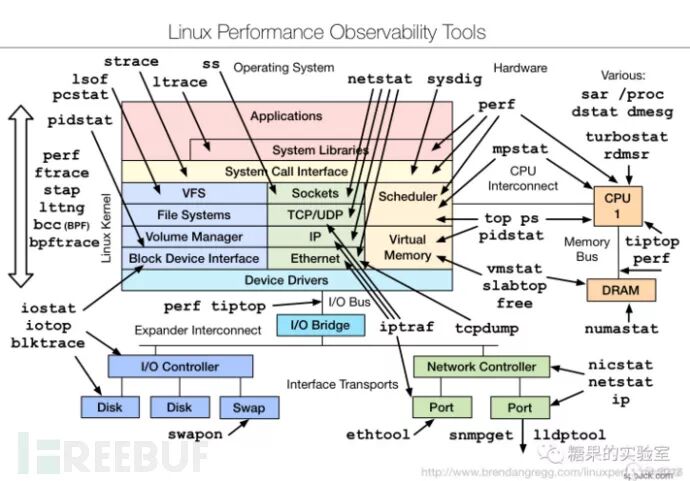
8 i* E+ N0 z9 m3 Y以上的图,可以看到工具是如何与操作系统交互取得底层数据,这种圆环套圆环,调用套调用的依赖关系, 如果都能简化成SQL这种DSL业务语言,简直就是太方便,把各种分类的审计信息全变成虚表,让安全人员专注于业务数据的审计和策略的构建迭代, 支持一下OSQuery这种SQL的设计方案。, z0 |0 r& x+ G+ t$ g7 P
还有一个Agent结点集中管理后台问题。( B7 l* o) P# ~. ~3 x
OSQuery后台管理是有商业方案,但那不得花钱吗!所以有开源方案,如下:: P6 K2 }( I# t! e$ W. s
[color=#777575 !important]https://github.com/shengnoah/osctrl1 [' f: `1 X9 S, X
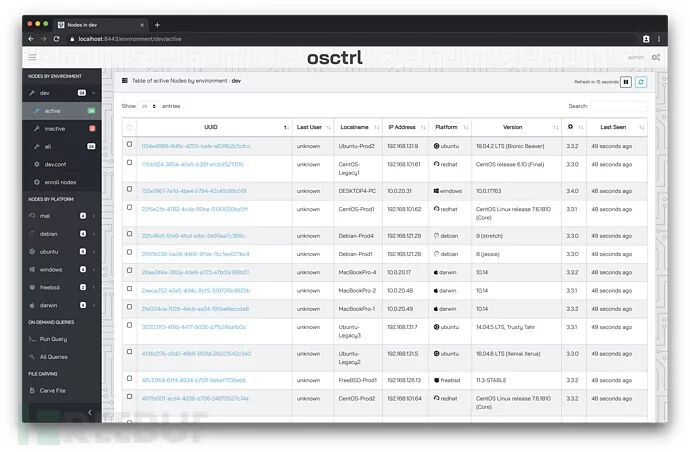
+ X N. T. Z' [6 zosctrl是jmpsec推出的后台管理系统,Freebsd、Ubuntu、Debian等各种平台都支持。
% L) b: h) Y1 H; X9 _4 X如果您使用的本身是基于ELK的方案,没有Hive、Clickhouse、Spark这些什么事,还可以选择Auditbeat方案, 是Elastic同门产品,并且Elastic还直接支持了SIEM,至于适用不适用企业就具体分析。4 Q4 W/ ]& {) s$ m
这样像SOC/SIEM类的产品, Elastic、Graylog、Splunk都有解决方案。前两者都有开源和企业版,后者是一定数据量之内处理不要钱, 过量就要钱,$ w+ [5 [) b2 n* G
如果企业的数据是,几十T,几百T的数据量,不花钱是不可能的。排除软件和运维成本,数据本身的生产,消费,存储的硬件成本就很明显的硬件成本。7 V. A ~5 h. R8 L. s
0x04 存储方案% A& o# A: {+ u/ K& V$ X4 P$ s
9 e" p$ T8 m, M( W1 d4 |" B/ S数据的存储:信息系统的一个核心是数据存储,数据库要保证基本的读写性能,扩展性,高可用性。4 Y2 c" e. J, G8 j0 {
现在有成熟的大数据存储解决方案。
* {6 l# T# b: i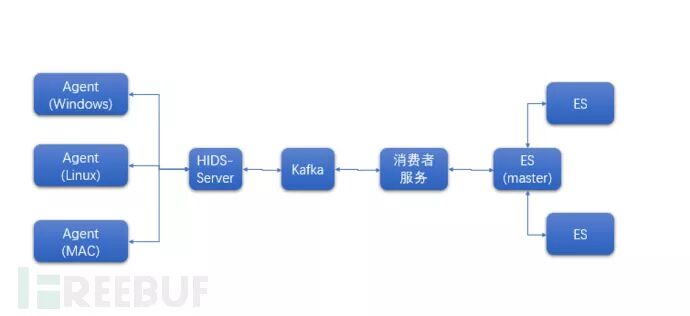 & M+ Z) e$ W$ S
ES集群核心存储方案(图2)
' N3 L4 [6 a1 pES:ES集群存储,最常见大数据方案之一,在实时计算场景, ES可以满足我们实时处理数据的要求。但同时ES的成本并不低。
/ A6 @9 W/ i/ A+ H7 g( x/ ^经过实践,ES集群为了稳定高可用,最少要用三台机器做结点,存两份数据的(1G的数据, 实际要用2G空间,有效使用空间低于2G),放到3台机器的不同分片, 这样才可能保证数据丢了可以找回来,要想达到数据访问的高性能,还需要配置高性的SSD磁盘。这都是钱。8 [- z6 H; s2 w7 K' L
只有ES不行,还需要配套的Buff队列Kafka前端机,前端消费机,只有带宽达到要求,缓存达到要求,才能保证存储服务的QPS。2万QPS至少12核左右的CPU,类推累计总消费量。$ W! l% {9 ^6 @, Y
ES优点:实时计算快,生态工具多。ES缺点:成本相对贵,需要配套的运维和调优。; j3 w [6 Z# G
需要专家配合才能让整个系统表现良好,默认的设置和优化的设置区别很大。) G v& A: i: T# v5 T
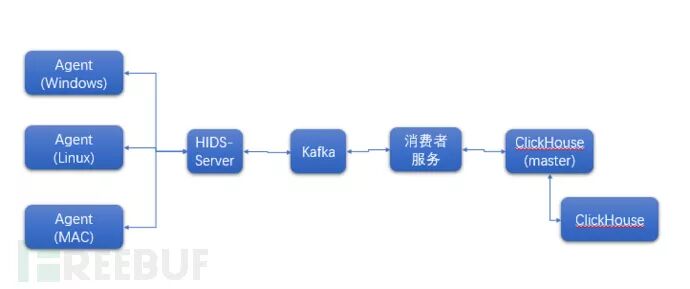
% s- _- z* b* I1 [ClickHouse集群核心存储方案(图3)
* O: D& f2 P' b5 L+ }3 h% ^ClickHouse:ClickHouse支持Mysql协议,存储空只需要原有数据的5分之1,1G的数据,200MB就可以保存(向高总致敬)。 并且检索的速度更快,相对使用机器更少。
; E* p% V, ~& u* p" M- K0 l4 _" GOSQuery在收集取得审计数据时,使用的SQL结构化语言,ES也可以支持针对Index的Mysql查询,但从速度性能上看,ClickHouse最有优势(个人体验),并且ClickHouse本身就原生的支持SQL。
9 t0 Z+ C1 i* A1 c. R0 }: I如果熟悉ClickHouse技术栈,Clickhouse也是一种主案,Clickhouse也同样需要前端机Kafka队列,也需要写Kafka数据,只是由原来的从Kafka写入ES,变成写入Clickhouse。
1 R1 l8 g# q- G8 B$ d0 Y, }[color=#777575 !important]ClickHouse优点:存储空间小,速度性能快, 学习曲线不陡。ClickHouse缺点:生态没态ES多,需要自己实现一些服务工具链。
6 O' X8 N6 a: j7 D3 j1 a 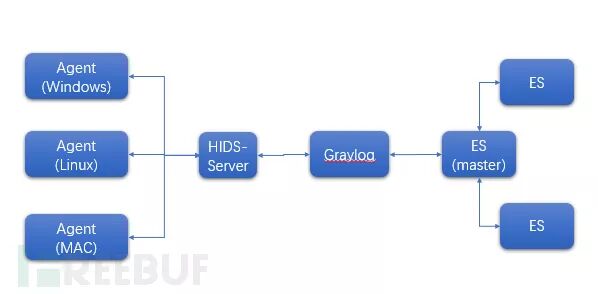 ; w1 j7 `. S. u" C. Y
Graylog集群核心存储方案(图4)
* T3 R5 [0 ? U7 Y0 R6 V: OGraylog作为一个开源解决方案,本身就把自己定位成了SOC/SIM系统,新版的Graylog有审计Agent的对接,OSQuery方案,适应多种平台的审计数据采集,(Linux、Windwos、MAC),支持威胁情报管理。Graylog是基于Java技术栈的,整体打包了Kafka和消费程序,由Graylog组成的集群,整体解决了数据前端数据缓存到消费到ES上有服务流程, 还有Buff数据持久化等各种特性,这个之前糖果的实验室的公号和FB专栏发布的文章都有介绍,不太具体展开。Graylog在与ES配合的过程,需要优化配置才能有更好的性能表现, 默认的Graylog原生需要调配的,不然可能会达不到您的预期,在数据管理上造成困扰, 有时不是Graylog本身的问题,是配置方案选择的原因,需要专家积累和测试。; Y6 N% p- j$ e1 C6 H# N ]: r
Hadopp集群核心存储方案$ {3 O- |! Z6 j2 i4 a# L- D* z. h. |" [
Hadoop:Hadoop要求存储空间是原文本的3倍, 对于中小规模的系统,几千台的服务器。如果用10T的数据存储,整个的实际的空间就要30T,而实际实时性上,不一定比ES和Clickhouse快。
" H" A# `3 d' J7 B7 N数据存储的占比,HIDS几乎50%数据存储空间,都是在存储网络相关数据,其他类别数据5倍,甚至是50倍。HIDS系统的大头数据,是主机网络相关数据。
( J+ f5 W3 m0 D, W3 z4 [8 k; m% J[color=#777575 !important]优点:功能强大,生态强大。缺点:基础设施构建成本高,需要专业团队运维,不是一天两天玩的转。
) F$ N2 L" C' G) k5 Q: s0 ~5 x 除了以上的方案还有Spark等其它的方案,成熟的技术在公司内部本身都有(ES、Clickhouse、Spark、Hadoop), 最后我们根据过去的经验和当前形势综合考虑,最后选择ES方案。
& y# r& J- q+ j 数据分析:随着积累沉淀的数据变多,存储多不意味着系统产出的收益多。基于规则模式的古典分析模式,在超大规模的数据存储过程中,存在视角上的盲点,和人力运维的巨大成本。威胁变化多样,我们需要的不只是指那打那规则策略系统,需要系统有举一反三的能力, 有联想威胁能力。基于AI、基于NLP、基于规则、基于语议分析都可以数据收集后,对原始审计数据中的威胁进行发掘。HIDS收集的数据有时可对应的算法,是否可能被有效的挖掘出数据, 不是一概而论,因为太多数据类型的审计日志, 需要挖掘建模方法,有时模型和威胁元数据是同样重要的。
U( f3 _% u S- _ I F7 z( v) O数据交互:整个HIDS最主要的操作者还是安全运维人员,让HIDS可以让安装运维人员配置策略,像无数安全分析系统一样,将威胁信息统计汇总。对于闭环的系统来说, 不需要过多的确认, 直接将威胁信息推给安全人员,直接响应是最理想的,这样运维人员,基本上不上后台系统,等着系统推送威胁给我们就好的理想状态。+ R8 W' L: D0 r
[color=#777575 !important]“威胁告警是观点,不是结论。”一个百发百中的威胁发现系统,是需要完备的数据证据链路,提供支持,HIDS也只是数据链路上的一条。
6 j$ F; k( p5 }* e3 N 因为证据链不全,才有了后期再分析判断的中间过程, 如果证据事实确凿,行动就行了,关键是证据链不全,最后还是需要先分析, 再决策,然后才能不瞎行动。
/ W) G) ~8 `2 |! C* o0 A4 D9 c- N0x05 总结
+ H2 s( L+ V2 Z( n! n
" [% k- H6 b! B( |! A/ ]经过几种方案的对比, 最后我们在ES、Clickhouse、Hadoop之间选择了ES集群为中心的数据存储方案,只是在目前这个阶段,基于当前规模和成本的计算,综合数据威胁分析实时性考虑,我们选择了一个相对比较适合我们场景的方案,不同企业具体情况具体分析, 但是选案的原理和资源计算方法是可以参考的。
' E$ d+ y+ w; |) ~0 y9 b- T对于那些,没有成本预算自研HIDS中小型公司,可以选择多种开源方案解决OSQuery、AuditBeat、OSSEC总有一款适合您。% m1 _, r: | V8 g
参考:! t7 S4 X* W% m. R9 V$ M! {
; }9 Z* {+ f% G& ^$ Q/ u, h
Syscall Auditing at Scale
w, R" Y) E5 g! P5 [. x[color=#777575 !important]https://slack.engineering/syscall-auditing-at-scale-e6a3ca8ac1b8
) c. t/ u) Y8 y, ~9 t; F% B2 B *本文原创作者:糖果L5Q,本文属于FreeBuf原创奖励计划,未经许可禁止转载 ! Z( J. l* h; [. h9 |
8 B6 f$ o$ C7 _; ]$ f精彩推荐
* ~- s9 F4 `0 k1 c _ 0 h2 }3 e# N1 I; W4 h- N5 d; A/ r3 d
! L/ W* m% Q9 U3 b: g# j; ~* P 
0 o' ?8 D q8 I% |4 i) M) P0 J4 e1 N2 m7 g
" y2 x9 M1 Y( u- a% r* R" r' N
来源:http://mp.weixin.qq.com/s?src=11×tamp=1577106005&ver=2052&signature=TOp2rWi5tKlIEFwUHz3u7DT8-J9KpsMHyuuWNIrRy21lhopqTD0ukz7SndieKHTIernqgs3kZKI6rwJOD58oI59HVhFJ3n*jFdBv00VgP9CBeoI1-d9VRMCWrgAFjhsb&new=1
4 X0 s. N, _* n( i免责声明:如果侵犯了您的权益,请联系站长,我们会及时删除侵权内容,谢谢合作! |  |手机版|小黑屋|梦想之都-俊月星空
( 粤ICP备18056059号 )|网站地图


 发表于 2019-12-23 21:14:37

