|
机器之心报道
% c+ _! X3 b7 N- @" q" E5 H( e" M: A机器之心编辑部「DeepNumPy 可以写深度模型,且与经典 NumPy 100% 兼容」,AWS 副总裁 Smola 说,「深度图学习本领强大,Transformer 也可以分解为图」。「Julia 内建可微分编程,定义任何函数,他就会自动算出值以及梯度!」,Julia 创始人 Viral 说。这就是 WAIC 开发者日,属于开发者的节日。 - ~- t) S( |! c; h. c* P S
* h/ U \9 e Z
3 x; u6 n, C; l# m5 A/ pWAIC 世界人工智能大会已于近日在上海开幕。在昨天由机器之心承办的开发者日主单元上,阿里技术副总裁贾扬清、亚马逊机器学习副总裁 Alex Smola、百度 AI 技术平台体系执行总监吴甜、Julia 创始人 Viral、Skymind 联合创始人 Adam Gibson 做了精彩演讲。
/ g9 V5 c( T ?& f
9 Q, c( l5 p' l) v
$ i! i$ |3 M; P% w; k0 |" j阿里贾扬清:从 20 瓦到 20 兆瓦的大脑, H& G/ f3 ^. R7 O m5 d
: D, f# [. p9 @2 n: ~" J/ o( [+ `8 P+ Q. D; }% p
" w/ S/ ]( `/ v) @6 j k- e2 P- [从 20 瓦的人脑到 20 兆瓦的云智能,近年来,随着算力、算法、数据的蓬勃发展,机器学习的基础设施也完善了起来。在 WAIC 开发者日中,贾扬清第一个分享了他这几年在人工智能领域的一些探索和想法。
6 H# W7 V! b* Q, H5 @4 o
% N- L0 T% y! G6 R) H8 f( `0 m
) |+ T- b q: W/ O W U- t' l. m5 i0 t# k7 B
! D4 N3 {! K. X- ~
! K/ F+ j) q1 v; f4 t2 h
贾扬清是知名的人工智能青年学者,在加入阿里巴巴之前,他曾任 Facebook AI 架构部门总监,负责前沿 AI 平台的开发。在深度学习研究、工程、框架等诸多方面,贾扬清有众多为人所熟知的工作。今年 3 月,贾扬清正式宣布加入阿里巴巴,担任技术副总裁岗位,领导大数据计算平台的研发工作。
. h; F0 ?* F; \- \3 A* [/ s% C6 B. @. S9 L- i8 N Y7 Q
- d `1 G b8 R+ x& h, o
在第一场分享中,贾扬清以《20 瓦,64 千瓦和 20 兆瓦的大脑》为题,从算法的潜力提升、算力的重要地位、数据的爆发式增长三方面讨论了这些年的 AI 发展,并最终表示「结合三者,云是 AI 的必然形式」。
/ Y0 ?2 S; l! D+ k6 X t
& u. s, C& c0 u
, O ?. K; T3 Q什么是算法的潜力 K. K! c, I" w1 R. f9 S. [
: Q& l% I# y1 }& g7 R4 n. s4 n+ L7 D6 y3 ~
人类大脑功率大约 20W,那么都能做些什么呢?这包括与环境交互、学习、推理等等。但是人工智能模拟起来却非常难,贾扬清最开始从经典机器学习算法讲到当前主流的算法,回顾了这些年算法潜力的变迁。举个简单的例子,机器学习需要图像特征,那么最开始是通过 HOG 获取简单的特征,后来发现「边缘」可能非常重要,因此各种卷积神经网络也就大显身手了。' `8 n; f. i. A# L
' \; Q/ S' h! ^4 }
) }9 k+ H1 g7 P/ q$ q$ r; f深度神经网络大大提升了算法的潜力,贾扬清举了个案例,在 ImageNet 图像识别挑战赛中,最开始 SVM 等经典算法已经到头了,但那时它们的潜力也只能支持达到 25% 的错误率。但随着 AlexNet 的提出,错误率瞬间就降到了 15%,而且重要的是,这种方法有很大的潜力,之后的研究使 ImageNet 的错误率一直在降低,甚至低于「人类」识别错误率 5%。
% f0 a4 N4 g( k" X: A7 u/ z6 e. s+ Y' t8 M) h0 Z( V; _: W- y
4 H/ U- v0 [, I4 R) t. z( I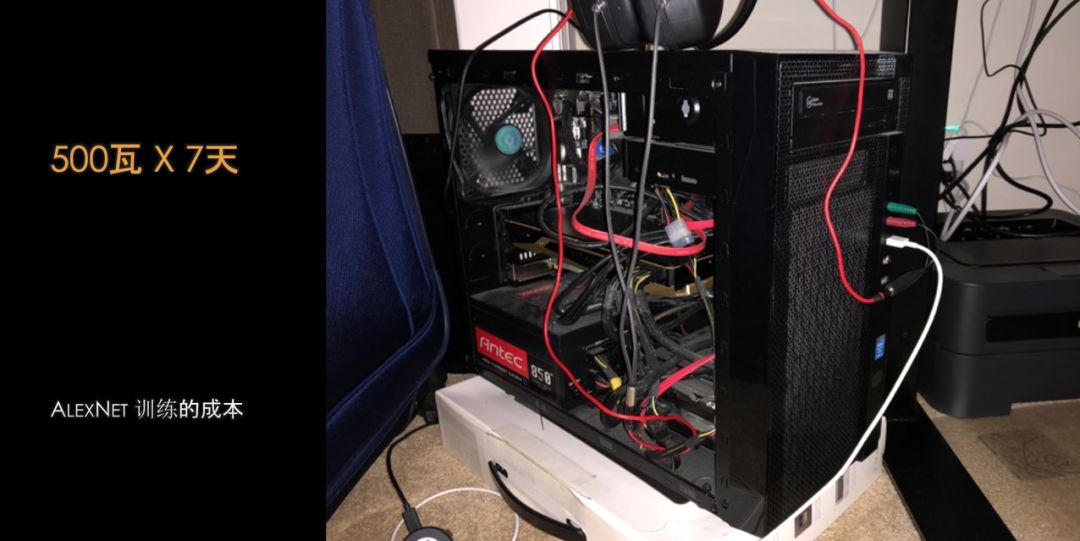
; O. q# b$ @, m* E! Q& g+ ?+ v8 [! i' \
2 y* Y: _3 }" w9 \% s3 |" b深度学习利用强大的拟合能力大大扩展了算法潜力,现在算法问题已经解决了,那么算力问题呢,我们该怎样利用计算系统提升训练速度?" _: f4 X, b" @ {' A' @
# A! K: S2 O! W# g9 f7 h
# J) I, ?8 T8 a- t# j为什么需要算力、数据7 x( t% S4 o6 N C0 g
0 X; w* R8 q/ T" H* G) J1 |' [' n: p2 C' b5 s9 A# F _
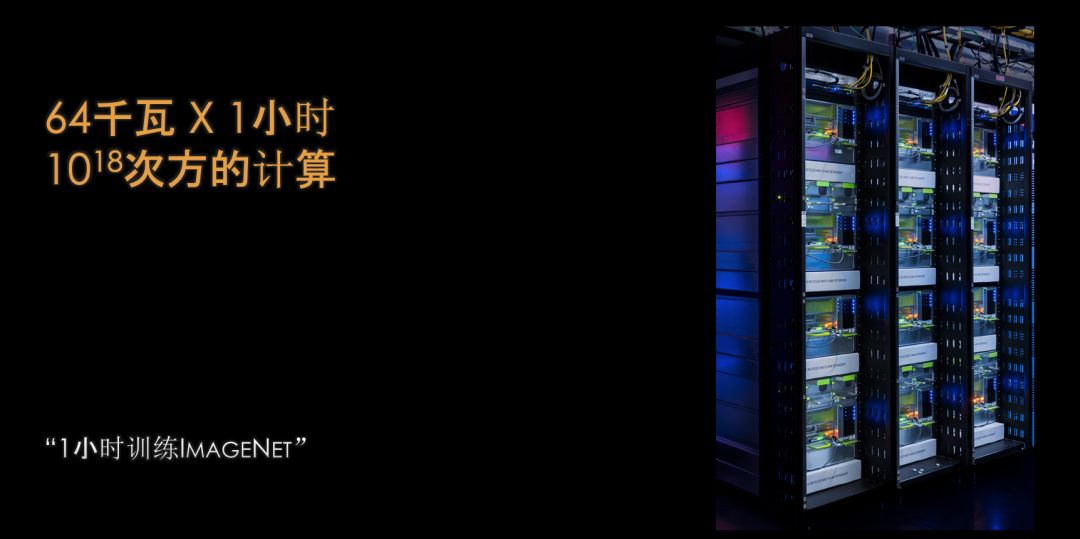
人脑的计算速度是有限的,但计算机可以通过堆算力来提高计算机系统或机器学习系统的能力。在这方面,人们一直在研究如何通过系统的方法提高训练速度。6 g0 E+ T7 E7 J, ^0 b; S
* x- G) Y. h' T6 l4 `
2 q; B' r1 ^, A& |
2014 年,机器识别一张图片里的内容要花 13 微秒左右,但今天,这一速度已提升了上百倍甚至上千倍。这一提升得益于 GPU 的聚合:单个 GPU 每秒只能处理 230 张图像,比人快不了多少,但 256 个 GPU 聚合在一起却可以处理 6 万张图像。因此,我们可以通过大量堆算力的方式来提高训练速度,这也是大家前几年不断努力做的一件事情。而这些 GPU 又通过分布式训练的方式进行合作。6 G, Z9 ?3 l: X
- \# i6 v6 I s( S4 ]3 o$ t2 q( P+ s, o* o+ `
 ]* f: M+ e" w0 ~- s
: B K1 U* U$ |) A! q
5 J$ \4 D, r- P: e' ?! M
如果说算法是潜在的能力,那么算力就是发挥潜力的保证。但是,算力将训练速度提升之后,模型的复杂度也随之提高。而模型越复杂,过拟合的可能性也就越大,因此我们还需要更多的数据来缓解过拟合。- t+ l4 @0 C/ M7 x
* D" R+ f! c w
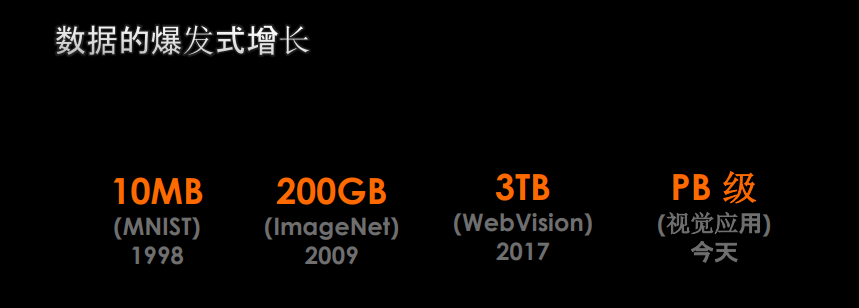
# F2 g+ F/ {" n8 }从 1989 年至今,训练模型所需的数据量也经历了爆炸式增长,从 MB 到 GB,再到 TB 和 PB。
$ G* v6 [/ d5 Y7 N* Q' B, M( ~* S0 k, t$ ~# }$ Z2 |
6 `; J' w5 u( z6 W# {' ?* J6 \
! s: N6 N: I% @9 i! _- ^ l
r: K# m+ f: X2 V! K$ h9 x7 Z
. M! i' \$ b5 a5 ]20 兆瓦的大脑4 R- I& k- S* H9 d6 D; V7 a$ S
$ d' X, z. y, D( x! v5 N
+ _9 a5 J8 r& i+ g, w8 p7 r有了高效的算法、海量的数据和庞大的算力,那么怎样才能将它们聚合在一起并应用到实际业务中呢?贾扬清表示,很多科技巨头都是通过云的方式来解决,也就是通过 20 兆瓦的大脑解决。) x7 R4 l2 {8 k2 l! m$ B% Z
+ V6 \; `4 C- e5 r
/ |1 i; _. Q% \+ E
贾扬清说:「为什么我们说只有通过云这种模式,才能够实现机器学习的创新?是因为云向我们提供了更大的规模、更高的可用性、更强大的安全性。」
8 `% P) }" d ?! y
) N# @0 T! w: u a) \' ]: g
: G$ j+ v* B3 H; C, o2 T6 [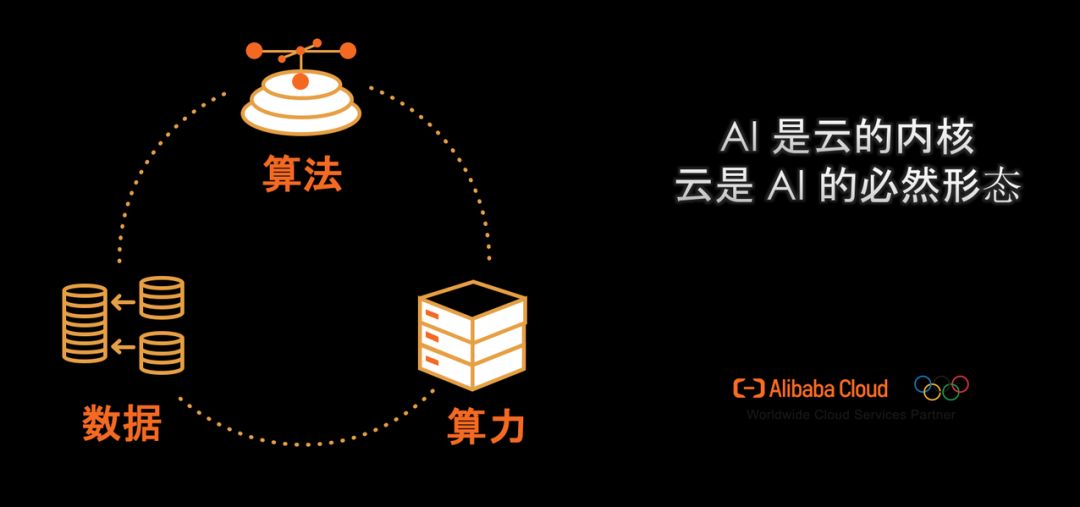 1 A8 x9 [! ~+ Z: p8 R$ |
/ U% |% x5 f5 X1 r" u$ z, d
% n" d' F% _- \* d2 `0 |
此外对于公司来说,我们关注的应该是业务,而不是基础架构这些东西,所以云能很好地解决这些问题。贾扬清说:「从 20 瓦的大脑到 20 兆瓦的大脑,我非常高兴的是我们一直在解决各种问题,希望联合算力、算法和数据,从而不断趋近于真正的智能。」+ B# G# Q: b4 ]2 e% t4 @0 C, S% s
; y' S% s' p3 S2 s. Z" n( N' H
o9 t6 ^; K# Z# _& h
「AI 与云的结合是一条必经之路」,贾扬清总结道,「我从一个研究者开始逐渐转向了工程、转向了业务、转向了更宽的思考范围,从而将 AI 向前推动地更远,这是我非常兴奋的一点。」
" L0 y2 I' L; X- C5 h. G, Y
; s n+ I1 I [0 |( y( o
7 r, }4 ?( s9 c2 o- K' e6 u亚马逊 Alex Smola:深度 NumPy 与深度图学习 - {5 c% N: |& C% u. ^6 E
`0 A" @3 _$ O) D- ^7 `# M( p- c4 w% Z7 a; M) I3 ~7 C
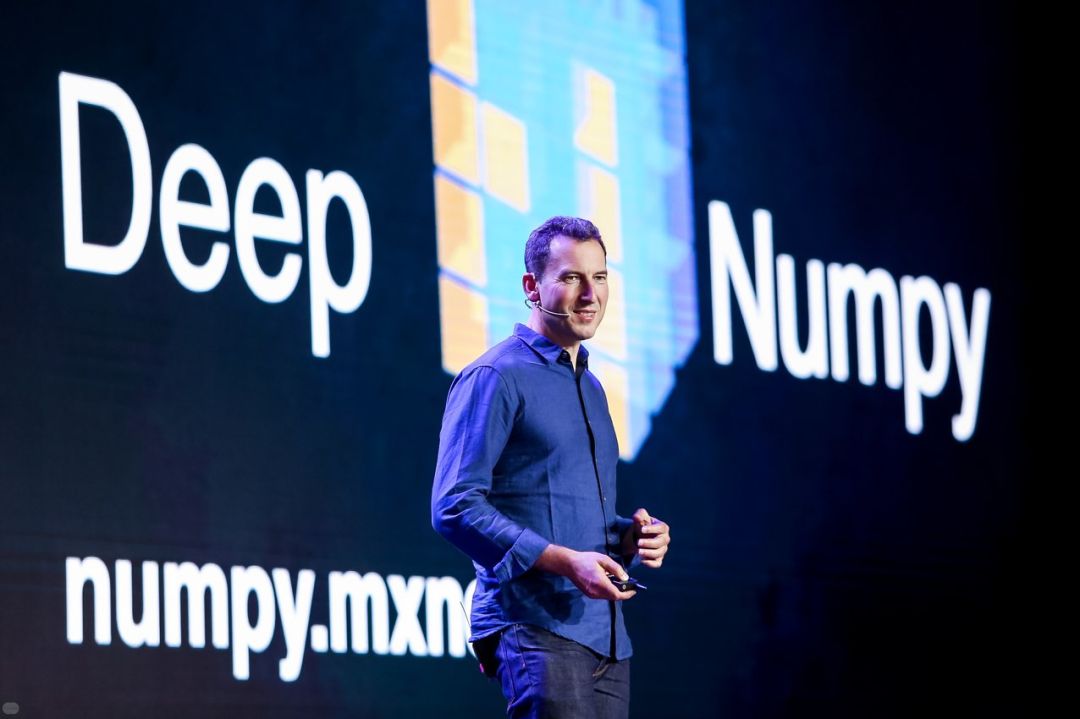
NumPy 差不多是所有机器学习开发者必须了解的库,它为 Python 附上了数值计算的「灵魂」。然而随着深度学习框架的流行,NumPy 似乎已经不再闪耀。那么我们是不是能为 NumPy 插上「Deep」的翅膀,用 NumPy 的 API 直接构建并训练深度模型?这就是 Alex Smola 为我们介绍的 DeepNumPy。& p S: t9 p' R& |) ]
7 Z& t# Y% _8 \
9 f" E( q; x4 N
 # _# S# ~) M7 F8 ^3 b3 i
$ L4 ^9 Y+ l }# G- u/ ~4 A7 X0 ~
除此之外,Alex Smola 在开发者日上还重点介绍了图神经网络框架 DGL,它与 DeepNumPy 共同为开发者提供最好用的工具与 API。
, ^& M: _. F" z; f# K: ~ j" h8 `( L( @& s3 S6 m' L1 @) r5 O, @
9 M2 X1 j | `; i6 R
Alex Smola 于 2016 年 8 月加入 AWS,现在是 AWS 副总裁和杰出科学家。Smola 被公认为世界顶级机器学习专家之一,他在 2013 年加入 CMU,并担任教授。Alex 是学术研究界的一位多产且被广泛引用的作者,撰写或贡献了近 500 篇论文,引用量达 75000 多次。9 d* E, ?& j ~
" Y8 G4 ]9 u! b. f8 V9 [. p( { D& M4 p( o5 o; ^- i1 s' \
下面,让我们看看 Smola 大神在 WAIC 开发者日上介绍的《Deep NumPy and DGL》都有什么吧。
2 Q1 w% g8 u% i: o0 n5 T# m0 i* `2 y/ I1 V; }
& O( D" O; _+ W
DeepNumPy$ M9 i( m3 U; N1 f* X
1 S; Q6 Q. j& Q
8 C5 n1 T! c* a. R% Y- ?; v kSmola 先让我们思考思考,到底机器学习的开发流程是什么样的?这时候我们就会发现 NumPy 即使在深度学习时代,也有非常多的应用。我们习惯了在预处理时使用 NumPy,在预测和可视化时使用 NumPy,甚至在不同模块间传递张量也用 NumPy。除了核心的模型搭建与训练,似乎其它流程都能用 NumPy。8 a4 y9 h' z8 _ k% |
9 |* n! [' [ W" N3 e( M
: i2 f) z( k! P9 {- l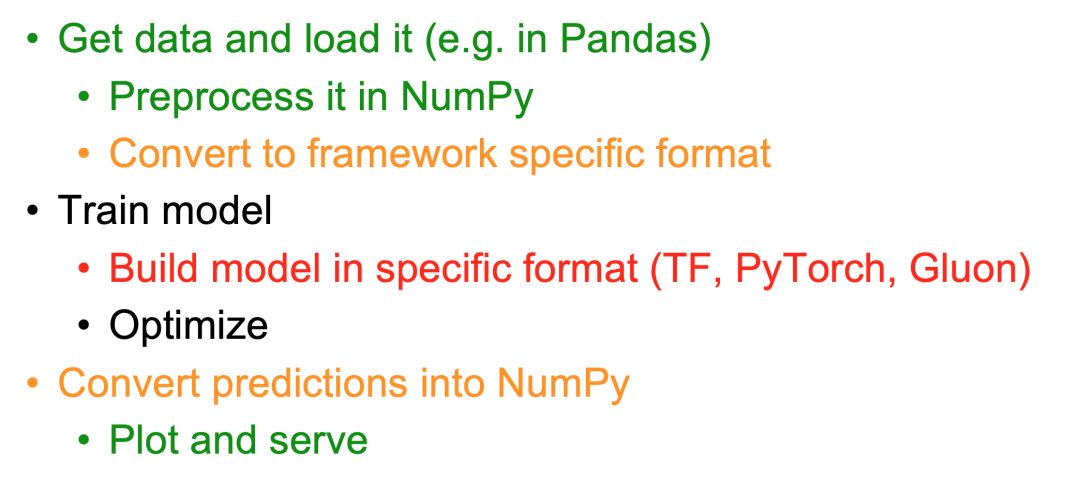 3 ^+ g7 f/ J6 t6 ^/ I
7 G: o v3 I0 y8 p' Y5 D2 \/ g0 V) M' R- p6 F
那么 NumPy 既然在矩阵运算、数据处理等需要 CPU 的环境下如此强大,我们为什么不直接将它迁移到 GPU,并赋予神经网络 API、自动微分等能力,这样不更方便么?Smola 表示,MXNet 社区正在做这样的事,希望构建和 NumPy 100% 兼容且还能搭建神经网络的工具。
, h" C Q" M$ ?/ `1 O' ~& P- y4 S. G9 R' l" k, D+ t
! V7 r1 e- S5 \5 j: X7 ]; B( h" u9 c7 e5 Z0 W" w7 s) k+ z
( C& `" L4 ~* \简单而言,DeepNumPy 作为 MXNet 的前端,它提供了类似 NumPy 的接口,且包含了一系列用于扩展深度学习能力的模块。DeepNumPy 主要包含两大部分,即 mxnet.np 和 mxnet.npx,其中第一部分用起来和 NumPy 是一样的,第二部分会提供更多扩展运算符,对深度学习更有优势。
8 q2 C$ w* a, h8 A; [0 f
, p7 }- b, c2 ^! c5 T' r8 @; }5 z, l& L8 G
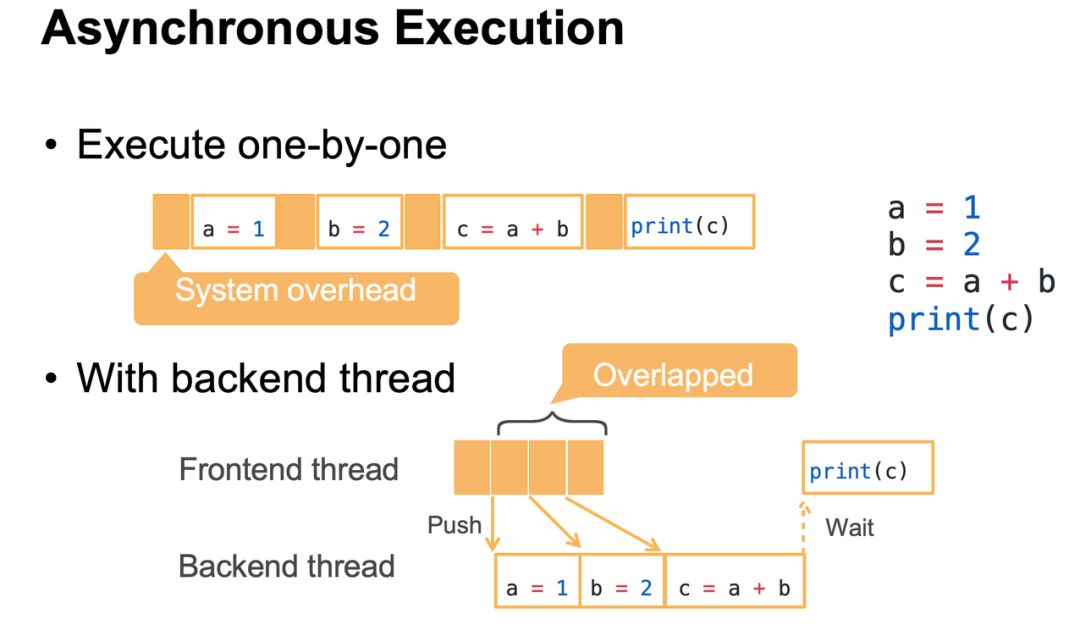
如下 Smola 在开发者日中主要介绍了 DeepNumPy 的两大特点,即异步执行与自动并行化。异步执行的优势与过程如下图所示:8 [ `, j4 G- g& @2 R" I' l$ V u
; X" j; U. _2 S* Q
* h2 r/ y* c! Z5 I
9 }3 A. w0 M9 ?) e
6 J! ]7 Z; [& K
) ~" T Y2 r8 R$ `1 ^; G一般而言,我们写的语句是一行行执行的,且系统的成本也会和真实运行加在一起。DeepNumPy 的优势在于,后端会以异步的形式处理前端运算。% l* _1 ?8 i5 K0 T
" D* g$ C' O* y6 @& @2 Z6 ^
' F" a, [4 O( ^2 ?8 A% a7 gSmola 表示 DeepNumPy 另一个优势是自动并行化,它可以自动解析不同变量之间的依赖性关系,然后优化运行路径。如以下例子所示,即使我们写的是一行行代码,但 DeepNumPy 可以将 B 和 C 两个不相关的变量并行处理,从而大大降低了运行时间。# ~0 N# ^! [, g- K
7 z E8 z6 ]. d3 V1 K, ~& u/ o
4 }4 L4 @! l9 M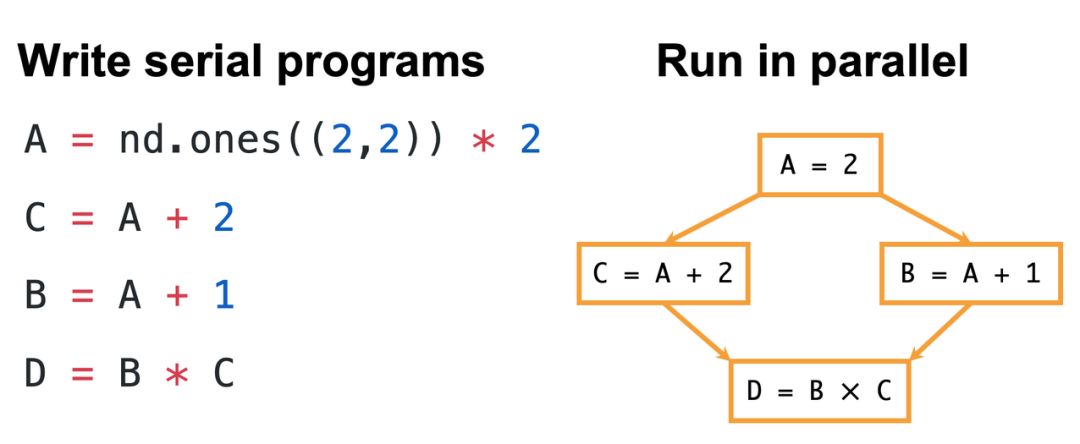
4 x4 k" U2 c1 t! w/ m. I: Q$ O X1 Z# e) q
3 f1 N: d1 ^- }1 y
Smola 总结道,DeepNumPy 在 Apache 开源组织的管理下,将继续修改各种 Bug、提供更多强大的新特性。目前 DeepNumPy 已经在通过 TVM 优化 Operator,以提供更多的便利,包括支持 CPU、GPU 和 ASIC 等其它硬件。此外在性能上,DeepNumPy 经过 OP 融合与定制化的调度机制,它即使在大模型上也能展现出非常优异的性能。. _! d3 B9 _5 \7 L' o7 ~- e
& _" ?5 f2 L8 x" |5 u2 R: o
6 D$ i4 ?' F" |5 _在听过 Smola 的介绍后,机器之心也查看了这一前沿的开源工作,虽然目前 API 文档还没有完善,但从一些案例中,我们发现它的使用方法真的和 NumPy 一模一样,不论是创建数组,还是执行索引、运算等常规操作,都有一股熟悉的味道。
S3 ^( M5 O* e% {- ?% @. b# L) W0 c/ l
5 d% ^/ c8 ]3 N1 N1 @4 b
Deep Graph Library
( ]! o1 ~! g- @5 C2 \# I) V6 d8 G! a" v/ B( d
3 S% a$ T+ J$ P; `# p3 {
Somola 另外重点介绍的就是深度图学习了,这也是近来非常受关注的研究方向。机器之心之前曾介绍过 AWS 开源的 DGL 库,那么现在让我们看看 Smola 眼中的深度图学习是什么样的。" j4 o- j6 u( i- i! {
( K$ R _, _( B5 |" d5 a( z$ C% D0 D& ?8 b1 f
首先 Smola 先定义了什么是图(Graph),以及它的一些应用,例如社交的推荐和欺诈检测等。图之所以这么重要,很大程度上在于它的表达能力,现实世界上很多数据都能用图来表示,差不多是最重要也是最通用的表示方法。然而深度神经网络擅长的是图像等非结构化数据,它基本上处理不了关系型数据,这就要求「图」算法有更新的发展。% G; f% K: f8 A3 k' |! P C
6 J: v; A5 q: Z+ ]
* ~- u6 w( L j" W5 d& D
" Y& A; g5 s6 o- }1 _
! D/ A/ f# S$ w; `
7 G" D0 U. E" ySmola 说:「DGL 是一个 Python 包,它为现存的张量数据库和图数据提供一个高效的接口。」为了完成这个目标,DGL 必须能兼容多个深度学习框架、必须提供最精简的 API,同时还要高效地并行图的计算。据 Smola 介绍,目前 DGL 已经支持图卷积网络和 TreeLSTM 等多种网络,也适用于很多应用场景。
/ G8 m P8 J; W; A$ E: q
7 @. x, @. h( E! o& v8 A6 g1 J y
- }4 k: C/ T& M/ \1 s! l# ySmola 举了个 Pagerank 的案例,它最开始是一种对网页重要性进行排序的算法。Pagerank 本质上是一种以网页之间的超链接个数和质量作为主要因素的排序算法,因此,我们也可以将网页视为节点,超链接视为连接的边,这样就能构建一个标准的图。
) ~# r" |, u4 l0 h* O
0 G& P6 u+ s& j( ^, C
: a, T- G ^, m% N" {0 C9 U; I如下所示为 DGL 实现 Pagerank 的代码,它的构建过程非常简洁。
2 D7 v7 K. F! m8 y1 F5 a9 \% ^9 s
4 U7 ?4 S0 n3 u7 b7 _5 _: U1 A2 W
1 F, B( y: \5 P5 S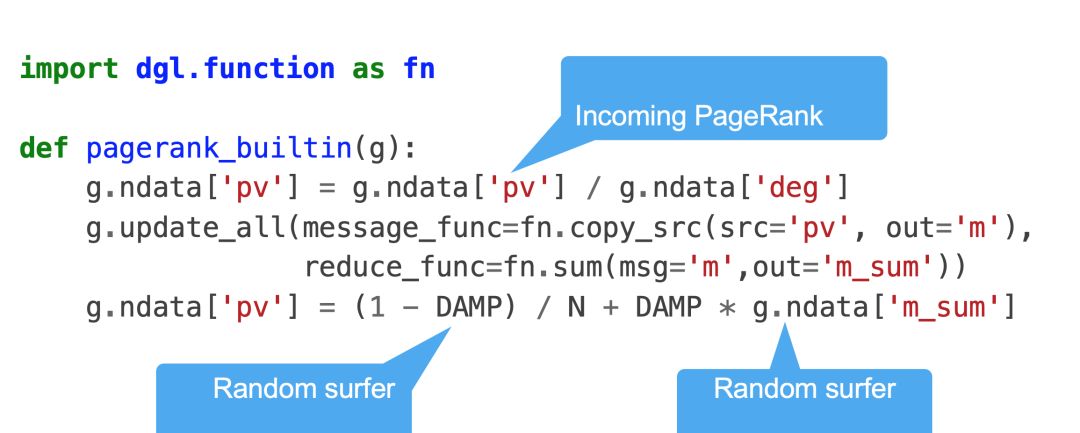
# r# |+ P" E' c1 h+ y2 M7 M0 @; H8 W& @: m1 M
- i" M7 ~6 C# I" x3 }" N
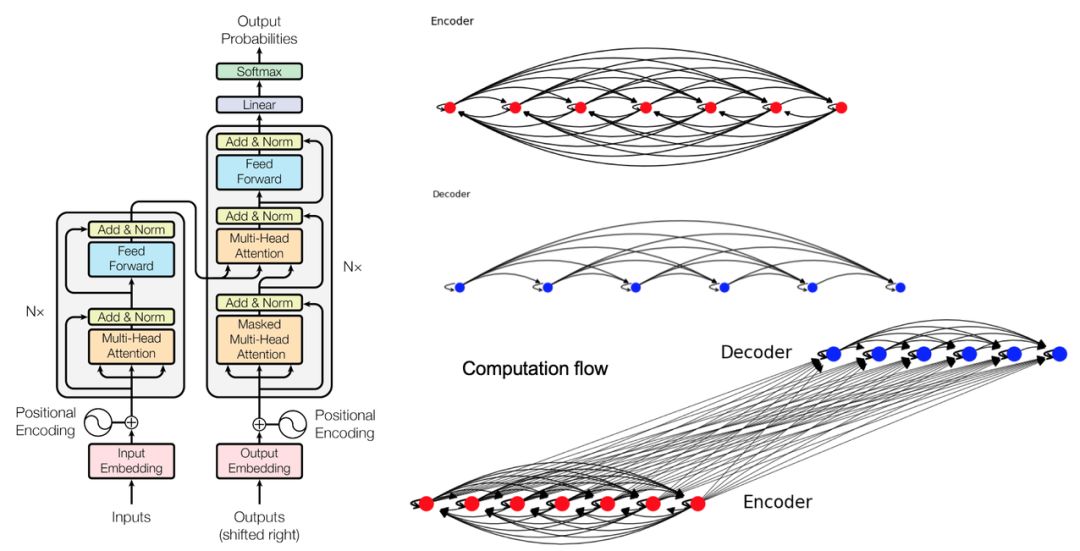
Smola 在现场还展示了更多用 DGL 建模复杂网络的案例,包括图卷积网络和 Tree-LSTM 等,其中非常有意思的是 Transformer,DGL 也可以将它分解为图,从而扩展它的能力。
- Q( W. h, G! s9 r+ [/ Z6 O& h
3 _. l0 D+ ]% X6 r* u" g- u0 N& N+ `
下图展示了 Transformer 如何解构为图,Smola 说:「我们可以将注意力视为图中的边,并采用边上的消息传递机制作为对应的运算过程,这样我们就可以将整个 Transformer 表示为图。具体而言,Transformer 可以由几个子图组成,其中 Encoder 建模的是原语言图,每一个 Token 即一个节点,不同节点间通过注意力进行连接。Decoder 也是一样,它建模的是目标语的图。」
' t1 E* X2 Z0 l @7 m i; k- Z6 x/ Z
! w/ `) I0 p3 V; {- h0 T* P% s8 A6 L9 w0 c
 - d' H: `6 y' n' e8 R
1 T# {: H: \+ V& f- L5 q6 Q
2 b% B/ {" m- E# ^$ [# }# |! KSmola 表示:「目标语的图是半完全的,也就是每一个词只能注意到已预测的历史词,它和原语言的完全图是不一样的。最后 Encoder 和 Decoder 相结合就能生成完整的 Transformer 图。」
6 V1 k5 ~! U4 g. A- g3 ~% ~7 `1 f) F* B3 t. ]
! _: j: x5 e! H5 o7 q2 j4 m E' ]" l
总体而言,听过 Smola 的演讲后,我们感觉图的应用要远比想象中多得多。像图像或文本这些一般神经网络能很好处理的数据,图神经网络同样也可以,甚至计算上有更好的优势。
$ v$ B7 r5 y! D+ I% l* p& Z4 o: E* s
, s6 y& x0 I; L+ u* n8 w, ?( i% ~百度吴甜:语言与知识技术产业应用创新与实践 4 @; w* J* |4 A. p4 B3 B
: _' u! N- N- J( f
% ]( l; n- P l5 O6 @: P以技术落地为落脚点,在本次 WAIC 开发者日上,百度 AI 技术平台体系执行总监吴甜为我们带来了主题为《语言与知识技术产业应用创新与实践》的演讲。
" @+ n% k4 [& ?1 c' F% Z: V( R' x& N
/ m' R" }& y! @' a, |+ n
T5 }6 _, }0 v k; e w% q
9 t Y: g) J5 D+ z4 [' }! D7 ]& M$ X7 z
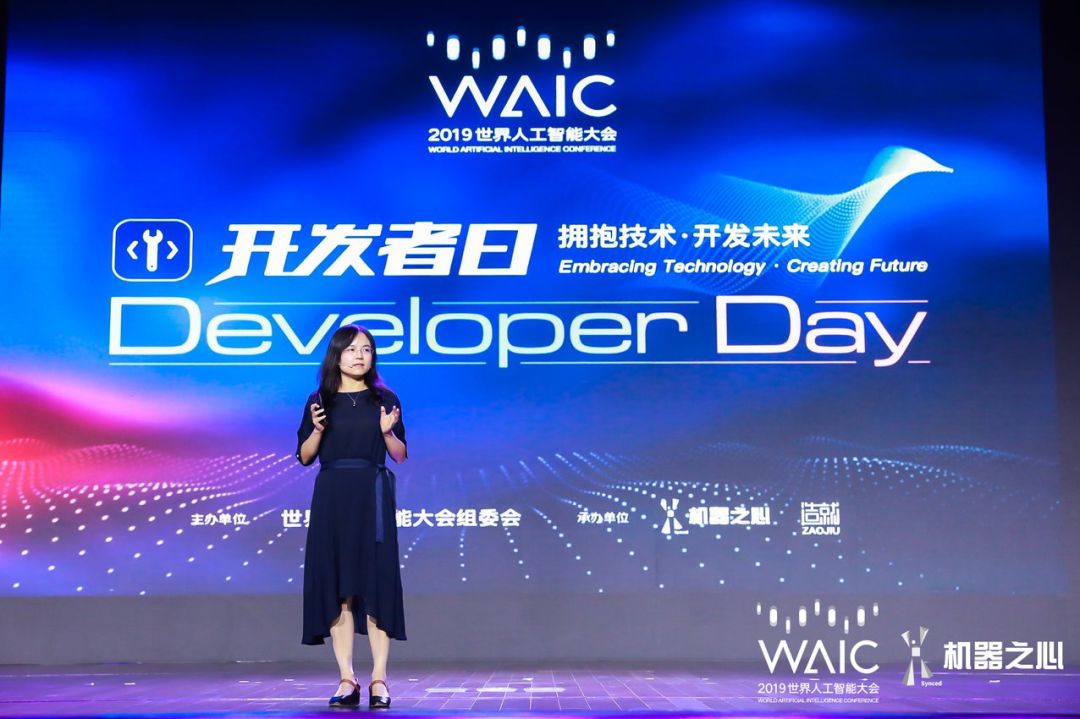
吴甜现为百度 AI 技术平台体系执行总监以及深度学习技术与应用国家工程实验室副主任。她主要负责百度自然语言处理、知识图谱、深度学习技术平台飞桨(PaddlePadddle)、百度大脑开放平台与生态等。
- {5 t" F+ Z7 O4 z+ `/ A) C) ?5 s2 {$ [4 p; ]: K
) Y0 a+ y; Z7 E" |! Y
百度语言与知识技术布局、发展历程和开放场景
0 M; b: K7 _& X. ^2 I& k- C6 g; c, y4 w+ H* i0 c
1 }# l1 x! u/ j" w+ V
吴甜开始逐一介绍百度语言与知识技术布局,其中底层的知识图谱是基础,中间层是语言理解和语言生成,最上层则是智能搜索、深度问答、对话系统、智能创作和机器翻译五个应用领域。
: Y, v2 u8 i2 V+ H, k8 j$ ] w+ ~) z0 `) ?
3 B$ a+ R) i/ u# I, ~) x2 d- e
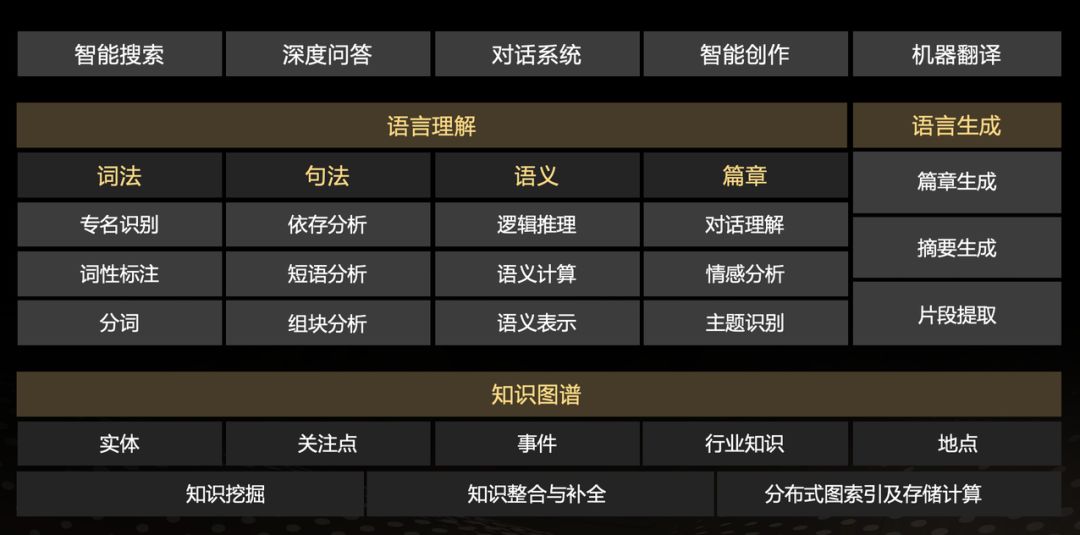
0 p0 j5 v% x' H; ^7 X3 D" o百度语言与知识技术布局。 4 y2 w/ ]# ?0 ? b8 L, H$ z4 `$ W
* \9 G0 P* c7 n0 p) H1 z
' Q' [4 W3 g9 O V5 d) N$ B这样完善的布局,它的发展也是有一些过程的,吴甜表示主要可以分为三个阶段:第一阶段始于 2000 年,主要集中于技术模块的集成;第二阶段始于 2014 年,开始将技术平台化;第三阶段始于 2017 年,开始开源开放大生产平台。- @0 [7 ?/ ?; ~: ]% m% E/ a$ k; N
7 E- v' ?3 B: l# w0 A% f% K7 q) j% x- @! m) O
那么百度大脑语言与知识技术开放全景究竟是怎样的呢?如下图所示,最底层是深度学习开源框架和平台 PaddlePaddle,倒数第二层是语言和知识领域的各项基础技术,往上是四个应用级平台,再往上是四种服务方式和各种场景方案。4 H: X0 ~- j# J# A( F
/ t) k7 X8 V5 s
b) H. _( M! o7 ^, C6 ^
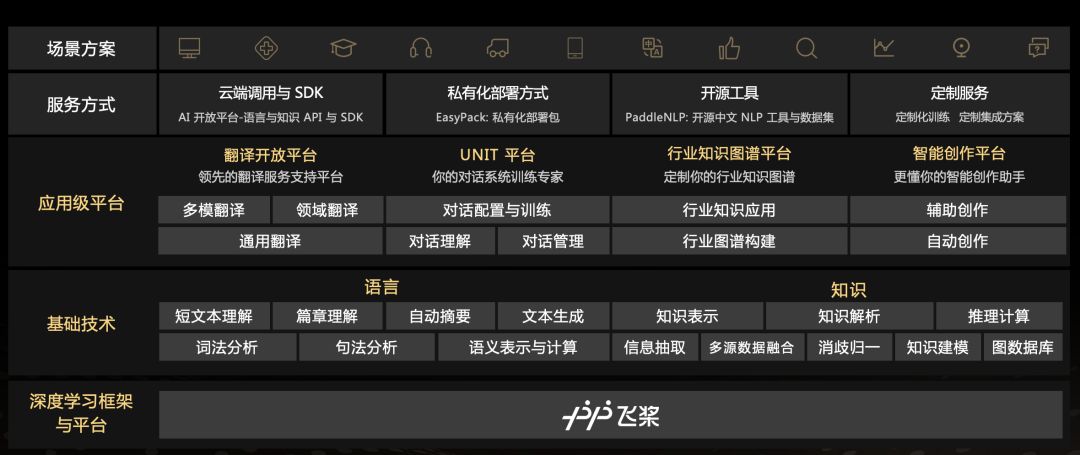
, E8 X, o2 L% W; f3 x% n2 ?百度大脑语言与知识技术开放全景。
* n* f+ i: [ ~6 a0 t7 a! {- i. @& b
' W, I$ G, {1 O0 r) x# w
百度在 NLP 又有什么样的重要成果?
8 Q( K: t$ E; X0 \- w; l- H: N1 v! l4 v8 Z! N! _
8 r: t" N: w! W- d1 t$ j9 g
百度在自然语言处理领域的重要成果包括语义表示预训练模型和今年 7 月份推出的持续学习语义理解框架 ERNIE。吴甜表示,ERNIT 已经累积了 13 亿+知识,其中包括 1500 万篇百科语料和词语实体知识、10 亿条网页搜索知识、700 万轮人类对话数据、2000 万对句子语义关系和 3 亿组篇章结构关系。
. \3 o' s. D) g. F( ]* p
( a# \8 j. k& i. D) r
1 M( @, W# _- v. A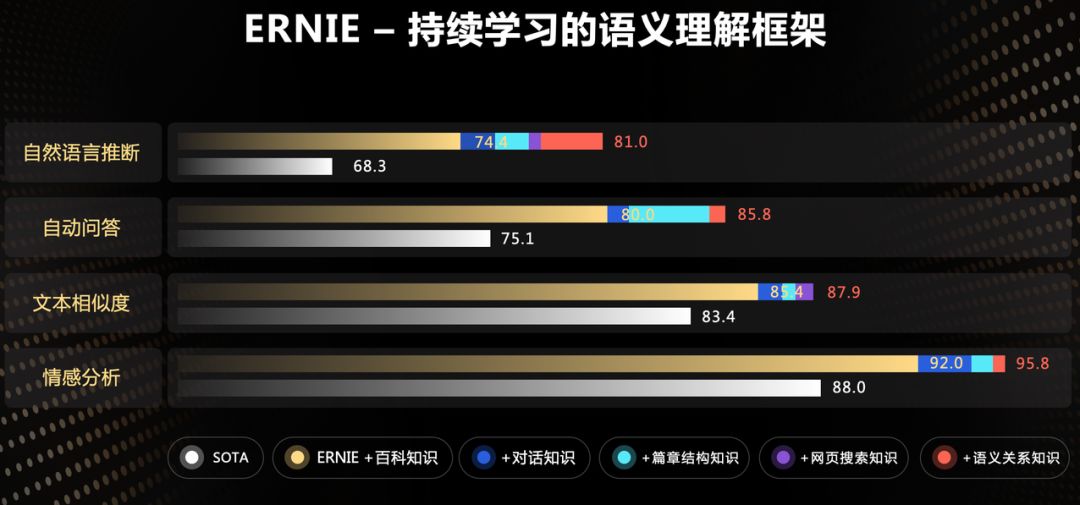 6 _( M% Z' w1 ^* w: a
持续学习的语义理解框架 ERNIE。 ! y' k+ ?3 v% G- j( \1 c- U
; n6 d3 t! K# @9 c0 r
! s$ h8 |/ h5 F6 @( q. H5 eERNIE 框架在工业应用上又有哪些效果呢?首先在智能问答场景中,如果将 ERNIE 模型应用于问题的分析和排序上,召回率就能提升了 7%;在加入 ERNIE 模型的情况下,广告的相关性也提升了 2.7%;ERNIE 模型能够使文本润色的准确率提升 7.3%;在对话理解场景中,ERNIE 模型将准确率也提升了 2%。
% N2 x. _! L. D5 a2 s9 w3 \2 _% z2 ^8 D
3 k$ ^& `9 l8 B$ t
PaddlePaddle 深度学习平台
# L4 [/ n8 k$ d9 Y, r. i4 B1 a/ [4 p1 H0 n8 D8 L
) f! C3 Z$ J- o0 e
但是要训练 ERNIE 这样的大模型,非常重要的一点就是提升训练速度。因此,百度推出了基于 PaddlePaddle 的 GPU 多机多卡训练加速,从而使得基于飞桨训练 ERNIE 模型多机加速比达到 77%。
* Z; K. d) T9 G( t. \) O
) u! c3 s* o' z" W
5 c2 \/ T9 t. _5 z8 b4 fPaddlePaddle 以深度学习框架为核心,从数据预处理到模型部署为深度学习的整个开发和应用流程提供了完整的工具。其中核心框架是从头构建模型的基础,而工具组建可以帮助我们快速训练与试验模型。最后的服务平台会为开发者提供整体流程支持。
; B8 y$ L8 |' F, H/ q# L9 v" T/ a" h
$ ^! h0 k( k/ Q7 u& l
* @6 L) y8 _/ |. P( H5 [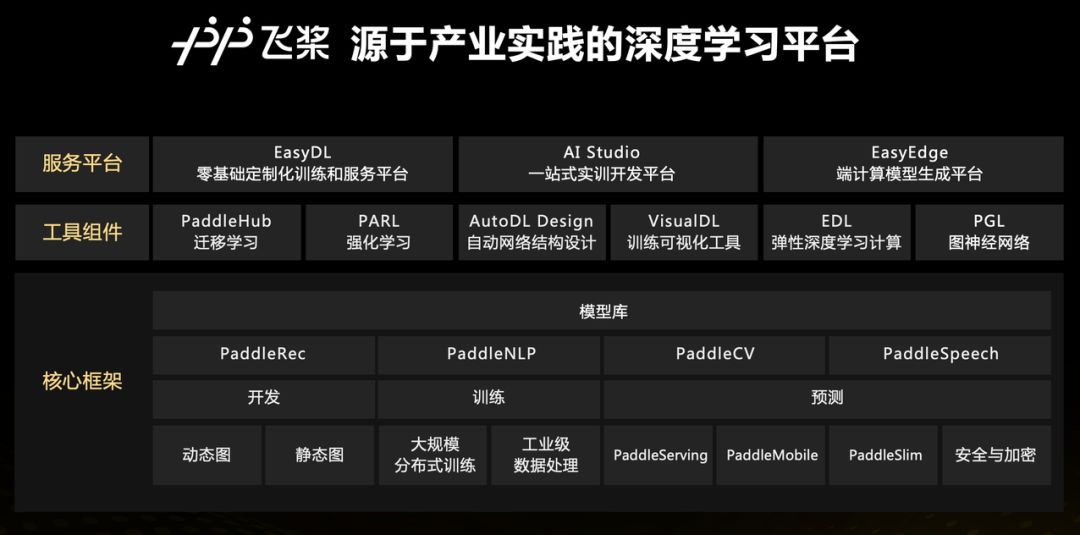 1 O9 L5 T: M# F9 k, b
2 u0 w9 X W6 s- x8 K0 i
! M" ~/ j* P( }: F7 j2 b& Y吴甜后面分别介绍了一键加载工业级预训练模型百度 PaddleHub 和面向工业应用的中文 NLP 开源数据集 PaddleNLP,后者提供共享工业级骨干代码,能够轻松适应领域需求。它们都是以飞桨为核心框架,并扩展它的能力。
: p6 g: m" ~( N9 N, v8 c- s l6 G Y3 h" \" k; a
! J) i6 ?4 q% A- o: ?5 t" ]
在 DL 平台和基础技术之上,吴甜以 UNIT(理解与交互技术)平台为例,介绍了应用级平台智能便捷性。UNIT 平台致力于打造为对话系统定制的专业、低成本、全链路的技术与服务平台,并已经为金融、教育等行业提供解决方案和服务。4 q* f. M: }) B ^# C& |( A4 b" R
$ \5 N, w4 S2 ~! o1 o
$ x" ?7 k6 k7 D5 KUNIT 平台核心技术包括语义理解、阅读理解和对话管理三大部分,其中 ERNIE SLU 可达到在同样理解精度下标注量降低 37%~72%,DataKit 可使数据生产效率提升 8 倍,使用语义理解 SLU 定制可使对话技能综合研发成本降低 60%。目前,UNIT 平台已实现 6.8 万定制技能,累计交互次数达 570 亿次,全面覆盖智能客服、智能出行、智能办公及其他智能交互场景,为一线开发者实现 AI 产业化提供有力工具。
e# h9 h2 U# B2 o( l& U2 f+ w! Z; }+ r6 ^1 c; L9 k6 t
' V& J) S# l, Y总体而言,百度的语言与知识技术就是在飞桨深度学习平台上,搭建完善基础技术和应用平台,从而构建更强大的 AI 基础设施。1 a6 n2 ~8 h% w( i( a0 x
7 p O' D2 t$ x
2 T& j, `& A6 I, M6 D8 d3 D
Julia 创始人 Viral B. Shah :天生支持可微分编程的 Julia
9 [6 o. M0 r7 j5 J) q$ a, S" N! V. U) W6 g- S- D* q" ^
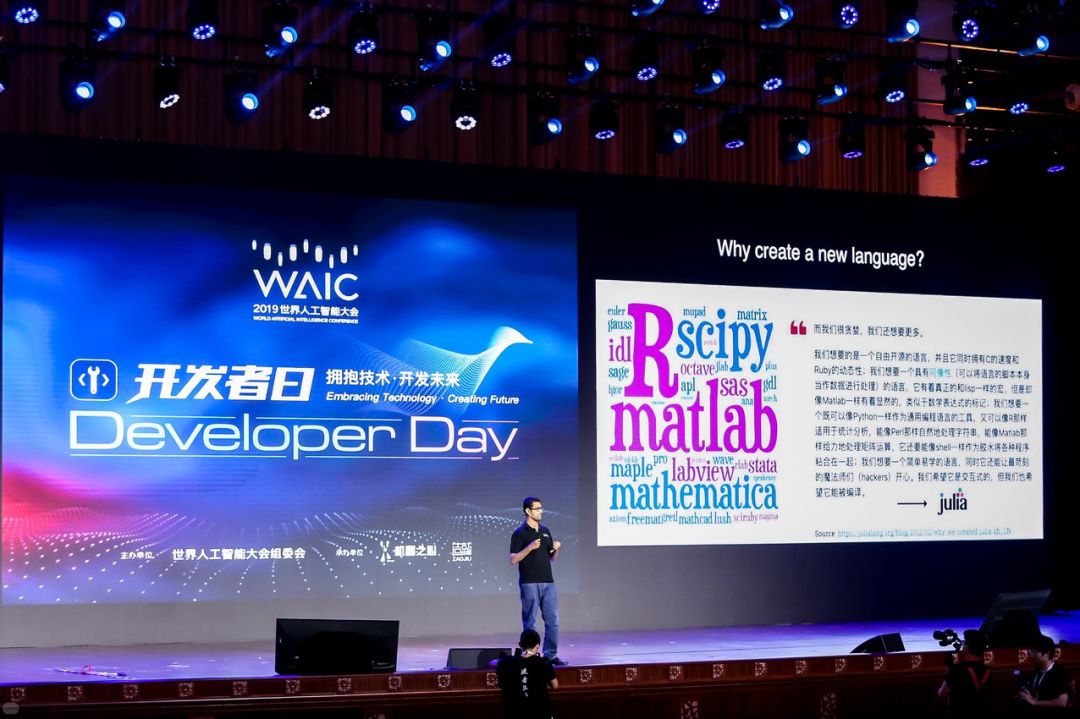
4 F2 }5 G# b/ J去年 8 月份,MIT 正式发布了 Julia 1.0,在开发者社区引起了很大的轰动。该语言旨在结合 C 的速度、Matlab 的数学表征、Python 的通用编程与 Shell 的胶水命令行。那么,Julia 语言以后该怎样走?Viral 在开发者日表示,只有内嵌可微编程系统,Julia 才能更适合深度学习开发,适合更广的科学运算。
( E4 E& J' K' l: y- f/ e% C# c& l. a& i( H- {* I
* o( Z) o, m% a |
1 o% j6 n9 b, T/ j
0 V/ |9 D4 h3 C% w: _2 q# m" _- A& V: x$ K
在本次的开发者日上,作为 Julia 创始人之一的 Viral B. Shah 博士重点介绍了为什么 Julia 适合做机器学习开发,以及 Julia 在科学计算与机器学习上的可微分编程探索。这种机制将内嵌于 Julia 语言,且因为没有中间语言的转换,它做深度学习、做反向传播的速度还要快于 DL 框架。$ Q; a2 G$ u7 l" B2 C
* j, l% g# n! N O
# r& u- \- b* P3 t, UViral B. Shah 拥有加州大学圣巴巴拉分校的计算机科学博士学位。他是 Julia 语言的创始人之一、Julia Computing 的联合创始人兼首席执行官,也是开源程序 Circuitscape 的作者之一。
/ o1 Z6 c3 z6 i" K( m& b# D
7 a6 M: F) x4 B5 S
. }) c; X0 h5 V5 y0 r拥有如此多的研究和开发经验,Viral 在开发者日介绍的《Julia: Generalizing Deep Learning and AI with Differentiable Programming》一定很有意思。+ i! ~+ D( I) z
+ P% c0 r/ v- e+ M! d O
8 J/ ^, K0 @! t4 t为什么 DL 需要新语言
5 k( Q6 A0 e# _9 D
4 \! Z3 p! m5 Y4 {1 G- @
8 K2 e- B& j# L K" sJulia 在中国已经有非常成熟的社区,它的性能优势也不可忽视。Viral 通过大牛的 Twitter 展示了为什么深度学习需要一种新的编程语言,不论是出于性能上的考虑,还是出于编程模式上的考虑,一种更专注于机器学习的语言都是有必要的。这种语言应该内嵌可微分编程的思想,并提供便捷的模型 API。. K7 R* K' U' a" D8 Q
% i' R. I, b( w' a1 `
; r) ~( M/ R& X+ b" b6 U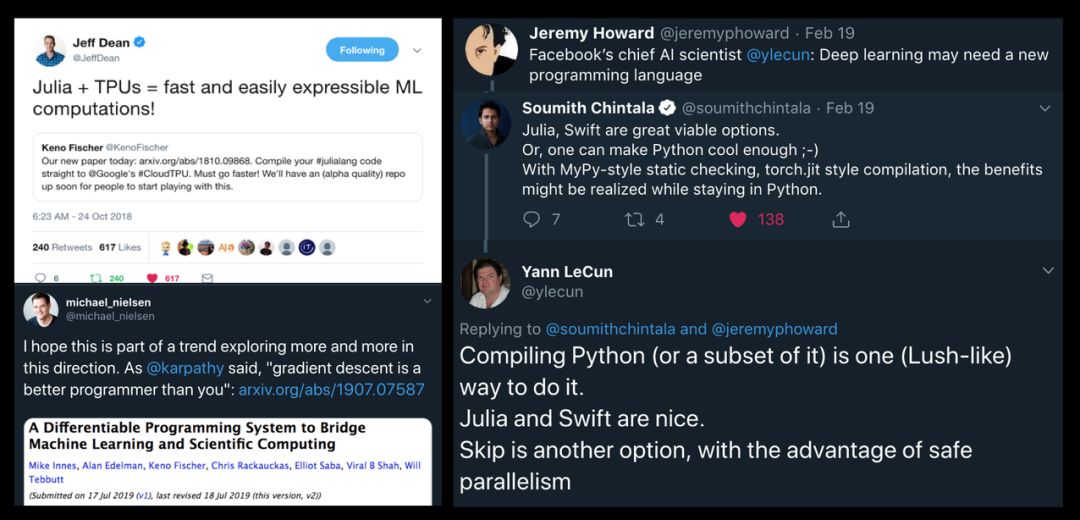 % T- C r8 H( e0 K. K2 r
2 B0 I8 ?8 F3 ]" o7 n4 f4 o3 ^) l0 _9 S6 h1 L5 W+ |' _
Julia 的可微分编程是什么样的
# R( U( B, Q! w1 l# F' Y7 { c7 H* M% {/ l
\/ a4 U; ?, D1 N
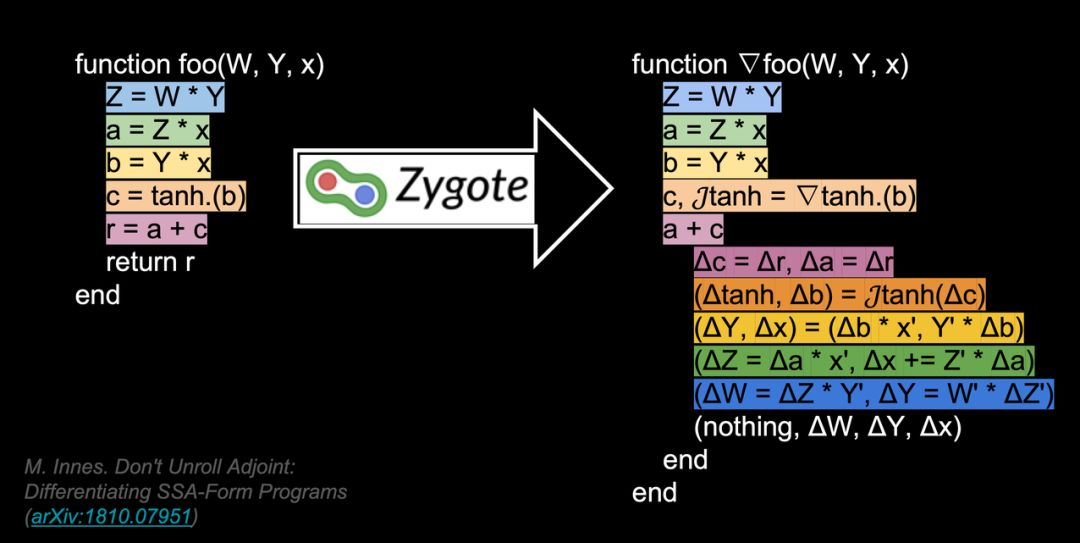
Viral 说:「我们最近也发过相关论文,尝试建立机器学习与科学计算之间的桥梁。这个名为 Zygote 地可微分编程模块将内嵌于 Julia 语言,并作为第一等的特性。可微编程最重要的特性是执行 source-to-source 的转换,自动微分转换基本上没有运行时开销,因此它要比反向传播的实际计算成本低很多。」
& y- k4 o' x5 N% A) c! ]; q6 W# E6 R; E1 ]: u2 [
2 B0 I5 v1 ]3 y2 f2 p如下所示 Viral 介绍了可微分编程与一般的编程有什么不同。) N7 Y6 D& g, c1 ?' r _& _
0 r) E* A6 w1 Z, b
( G; x+ F% Q m `
 4 b" L/ ?" ?' g
K! a* A# W. e7 R. g) ]2 j' Z
" {8 z3 _3 o d! _0 T" Z) @Viral 表示:「Zygote 可以对任何函数进行数值计算与梯度计算,只要我们如平常那样定义了函数或高级函数,那么 Julia 和编译器就能自动算出梯度。这种梯度可以用于进一步的运算,例如反向传播或梯度下降等。」这是 Julia 非常重要的一个特性,它能处理更广泛的任务,例如应用物理学或分子生物学等。; y( Y1 r8 s) _$ R4 V* D
" t( F& n0 i1 L) C. p: Z0 H
7 d" T1 V/ P: ?; O# q9 A! a: S「不止机器学习,其它广大领域的科学计算也需要利用这种可微分编程的优势。因为它们之间有很多相似的地方,例如都会使用最速下降、拟牛顿法等基于梯度的方法,都依赖线性代数等等。」,Viral 强调到。
' u) Z/ e V' f- U1 v- W; m* o7 \4 Z/ ]! v4 K q4 ~; A$ j
( X5 ]: n9 r4 R2 P
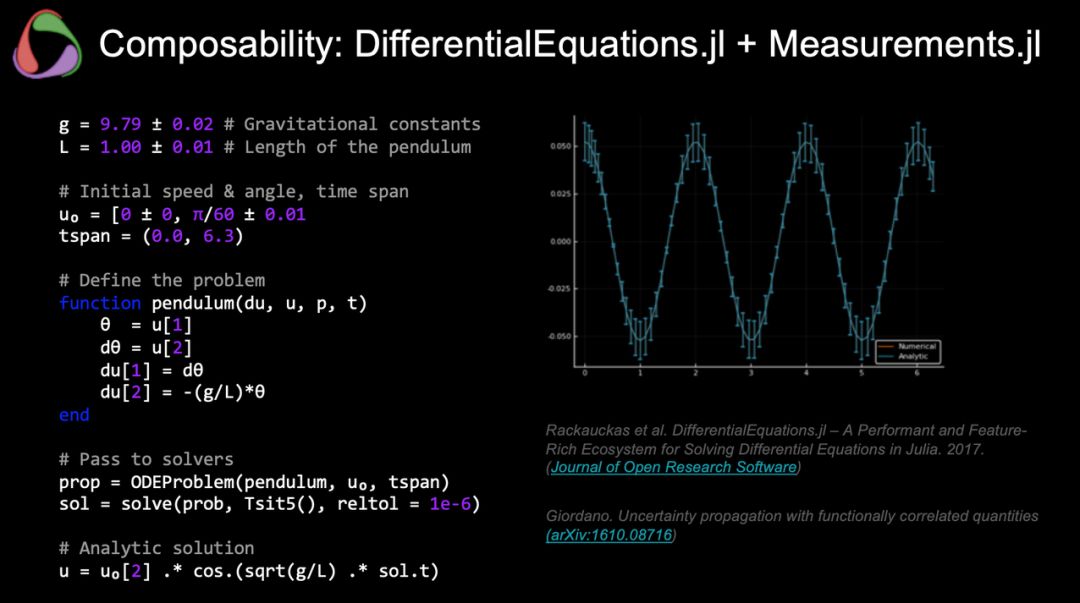
后面 Viral 还介绍了 Julia 与可微分编程的众多案例,如下主要展示了微分方程的应用。6 a( I! S/ T# x( v( y' V' B/ f: F5 ?
5 _% @6 h) G6 }1 C9 g; @
: a5 o5 {4 m$ R: h7 G$ z+ F
/ V9 |8 V3 W+ T5 ]" z; s( W4 M% Y$ W
T2 H3 w' e( q o) Y
3 G! w) D* a+ s" hSkymind Adam Gibson:AI 对第四次工业革命的推动 , v8 E& F6 @" D7 Y- @' W5 l0 ]
) ~$ Q w8 _/ g" ]
3 d" ]2 Y( L# `3 ]% k3 u5 z# n1 S自 18 世纪以来,人类社会先后经历了三次工业革命,从手工时代逐步过渡到蒸汽时代、电气时代和信息时代。而今,我们正在经历以基因、人工智能和清洁能源等技术为突破口的第四次工业革命。其中,人工智能是推动第四次工业革命进程的一股重要力量。- o- N9 `0 ~% A9 q: \0 r. O( c
3 `# c7 p* T2 Y( K3 C) k
6 l9 K9 e- t- [! ^
在本次的开发者日上,美国人工智能/机器学习公司 Skymind 联合创始人兼首席科学家 Adam Gibson 做了主题为《The Driving Force behind theFourth Industrial Revolution:Emerging of AI in Industrial Applications》的演讲。' d- o# x! C. {* A3 M6 Z
3 u+ z' A8 Z8 G# w N5 F1 t
/ L" j5 b) c' {$ p) X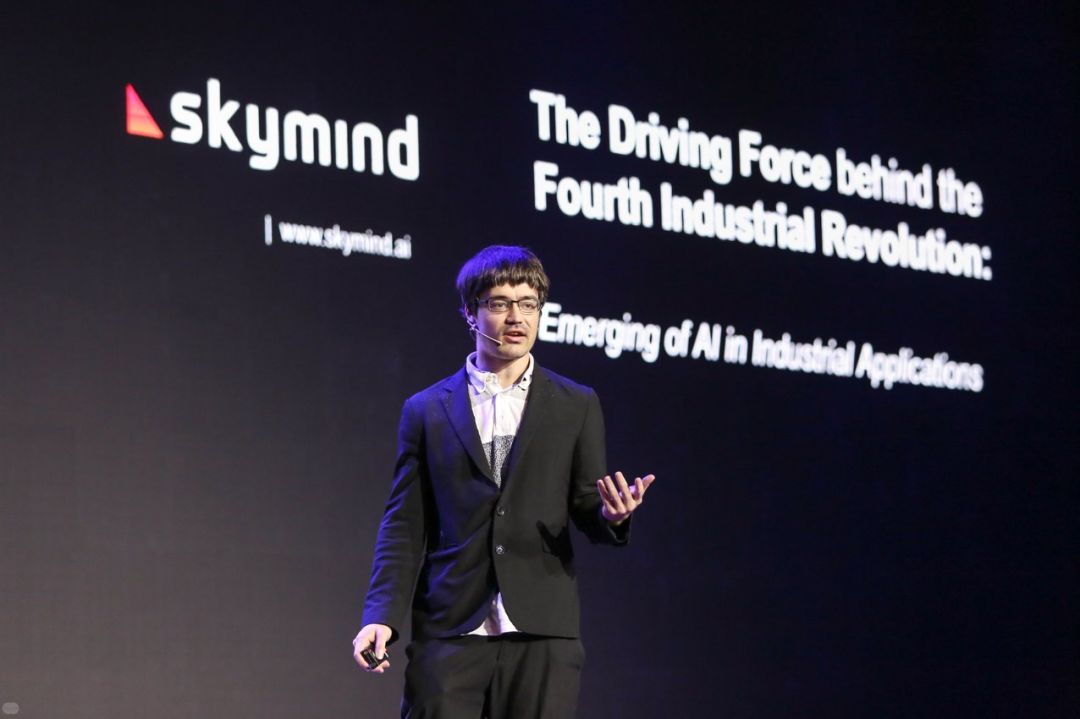 * _$ ^# {8 Z( }0 c5 W, u& f
除了创建 Skymind 之外,Adam Gibson 还是最广泛使用的开源机器学习库 Eclipse Deeplearning4j 的创建者以及旧金山 Galvanize 技术学校数据科学硕士课程的顾问。
& `* ~/ ?4 d: {# ]& j0 Z, a& T- t7 Z6 h) r0 `3 p4 ]
/ m0 v1 O; Q! T+ u0 PAdam Gibson 在演讲中指出,维护、维修、人机合作、生成式设计、供应链、产品优化、网络安全等都是工业 4.0 时代的推动力量。. R3 v! @! G) A" y, g
+ x! ]; d& Y/ B/ n d
1 V: a/ D7 _) k) @" O J" d. u$ ?企业中的 AI 应用现状! r4 T8 W; O% ?! B- u
2 O) }5 _6 ]+ e: ]
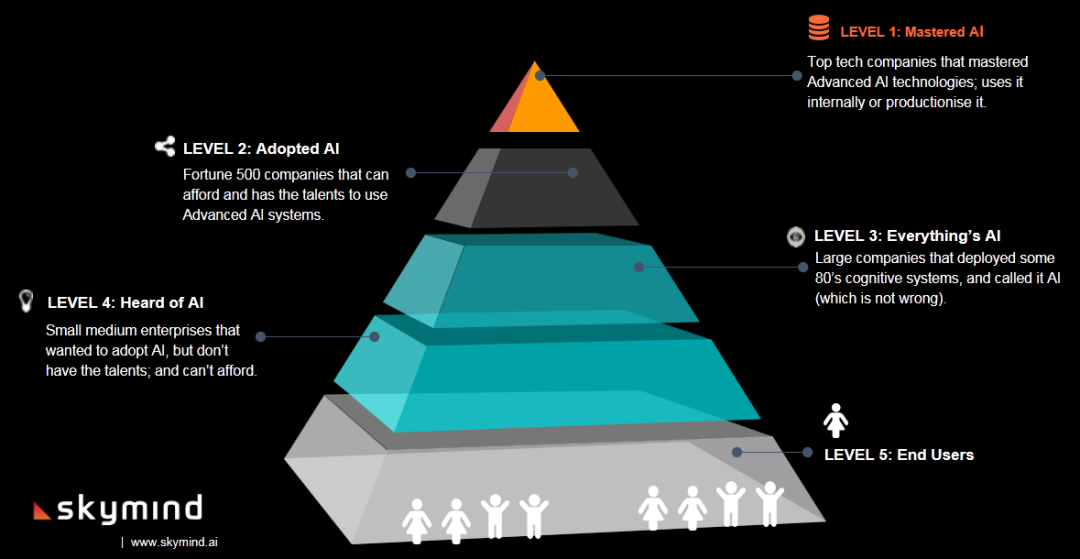
1 N' l/ G& [( n7 M$ b既然工业 4.0 的实现离不开 AI,那么 AI 在企业中的应用现状如何呢?Adam 指出,目前全球通过 AI 获取价值的企业还不到 5%,而且这 5% 的企业对 AI 的利用也大多不够充分。其中有些中小企业只是听说过 AI,但没有人才或资金来帮助实现 AI 的利用,还有些大公司声称自己用到了 AI,其实用的只是上世纪 80 年代的认知系统。只有极少数 500 强公司或顶尖科技公司才能足够的人才、资金利用先进的 AI 系统,并利用其产生价值。
3 |7 H1 r& x3 n$ ]
; q+ v+ |: x; u" ?: v5 z' [2 Z. ~# b' ?# q9 m; |: u% G
 ' E( O" c1 M; W! }* H% n# s0 }2 m
7 A$ e4 `0 H D! j6 C" ? W; ~. b: Y
此外,Adam 还指出,我们现在要做的就是降低 AI 的应用门槛,通过多样化的处理将学术研究成果转化为更加实用的现实应用。同时,我们还需要看到市场需求所在,还很多论文忽略了这一点。
4 o9 s- W. M( c: ]) X0 }% f0 D4 [+ c7 b0 G
/ Z, Y" ~9 U& e4 F2 ]/ C& K8 Z8 n9 P
如何在工业 4.0 中应用 AI?
/ d" i1 c c" y/ Y& n; Q" y% c& f/ p' t! S, I# S3 m
. F; A6 H8 W$ {1 s& g9 y% A0 @+ {除了上述人才、资金等条件外,在工业场景中应用 AI 首先需要解决数据问题,因为这些实时响应的工厂都是新颖而独特的,无法提供训练 AI 模型所需的大量数据。
) a i3 E% [+ b" }/ x. k" Z% R0 f/ y; o% f
6 K g7 a5 P8 a$ v: d0 W% v
# c: g! W9 ]' w3 ^- m9 o8 w$ V+ P对此,Adam Gibson 呈现的解决方案是将模拟与 AI 结合起来,即在模拟器中创建许多 AI 可以学习的可能场景,这也是强化学习模型的训练方式。
0 m" Y9 x0 A1 O
: F# l, l3 o% e, c! d$ n# @
: n' [* M5 G0 @. d T$ F7 Q强化学习不止与 Alpha Go 有关,同时也是我们通过模拟来做机器学习的一个分支。
& E+ w3 A' ^& G- v% W$ k8 d1 o8 g. G8 Y
4 u. n$ U+ {1 W& x
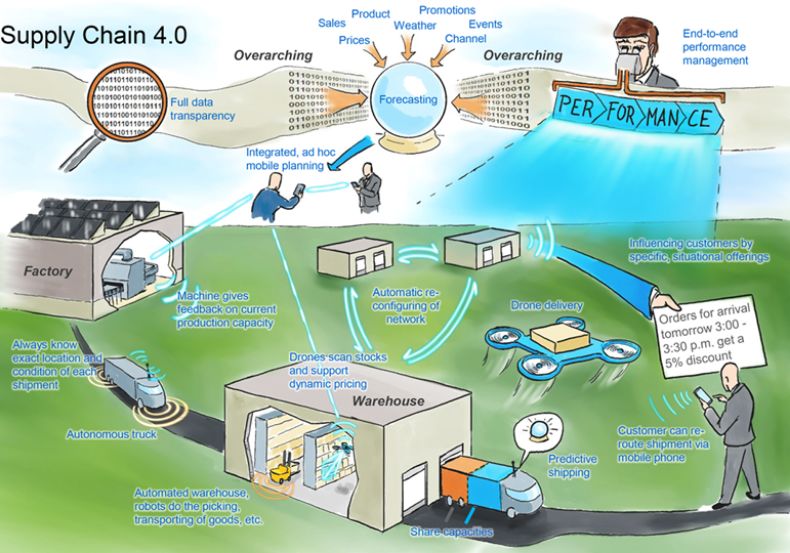
广告商如何投放广告才能实现效益最大化?物流公司如何优化送货路线才能降低成本?从供应链、智慧交通、人机协作再到工业流程模拟,工业 4.0 时代的许多问题其实都可以归结为 NP-Hard 问题,即组合优化问题,而强化学习为这些问题提供了一个可行的解决方案。利用强化学习学到的策略可以部署到各种设备中,以自适应的方式自动完成某些任务。
' Z3 P. h! D- @2 K2 T9 N
& P6 H. T+ W) a, y7 f% a* t, K d0 U" e' [& l _# w8 G
 2 F7 n" i( z/ X/ E( @( g7 \
& X9 i$ S/ W# W4 E+ k I N: z: \* W$ E$ x; t. d. a7 z. P w
此外,Adam 强调,在这些场景中,我们要打造的是一个端到端的解决方案,建造一个中心化的系统,把数据收集到一起,然后不断进行模拟、迭代。
9 q0 \, O7 f2 x5 l7 F) t
; g3 Y, o! h) y( E- r8 a( m& c4 S: _3 {& [( A( \
以上这些都是主单元的主题演讲的精彩内容。当日的主单元还包括WAIC黑客马拉松颁奖典礼、两个圆桌论坛等精彩环节。
- m. x8 Q' q* q9 Y- T3 W, Y
( k0 Z7 \ B) A7 ?# @3 \' x; O经过一天的高强度知识洗礼,相信大家都回味无穷,很多读者可能也都希望亲自听听大牛口中的「开发经验」都是什么样的。这里机器之心准备了重播链接,点击「阅读原文」观看整场 4 个多小时的知识盛宴。; Q- } w. j. M9 I6 Q L
6 ~+ m5 o1 J( m; O0 E5 `4 Q
6 P9 B9 h( d+ t6 B I! N! f' Z; u1 Z% F
9 g( k+ k8 R N7 q+ i本文为机器之心报道,转载请联系本公众号获得授权。' H0 k7 x. A& H% }
✄------------------------------------------------加入机器之心(全职记者 / 实习生):hr@jiqizhixin.com投稿或寻求报道:content@jiqizhixin.com广告 & 商务合作:bd@jiqizhixin.com; Y5 C8 A, a& s! k
来源:http://mp.weixin.qq.com/s?src=11×tamp=1567326604&ver=1825&signature=e5agdBSSGq8YPKsP8BOGJpnGqq*vhv6ldkToM8IdpYozvvXc2EguqwjYOASEXKBiaECAQzjFhxZHiiHtZ30YFZnvnVHxzKCnZdPaPW15Cr1oNsjkbuc1SZkdZSDRxb6q&new=1; r6 m3 N4 O D- e$ r% V; U
免责声明:如果侵犯了您的权益,请联系站长,我们会及时删除侵权内容,谢谢合作! |
 |手机版|小黑屋|梦想之都-俊月星空
( 粤ICP备18056059号 )|网站地图


 发表于 2019-9-1 16:49:57

