( w+ n$ D6 t3 K9 O市场被催熟,巨头进场收割。- w) s# h6 G2 T, b' j3 E$ O6 |
边缘智能,人工智能的最后一公里,很长一段时间里被创业者视为得以绕开巨头打压的蓝海市场,在今年开始有了微妙的变化。
5 \7 |* r# X8 Q; {4 @
" V7 l- R( J+ x3 ]9 t1 W
5 K* b- k7 o5 x8 `, ?
撰文 | 四月、力琴感谢机器之心海外记者袁渊提供相关资料 2 V- j" m1 E* v% T' @
11 月 13 日机器之心消息,北京时间今日凌晨 2 点,英特尔在旧金山举行 2019 人工智能峰会,推出从边缘到云端到全新 AI 芯片,包括下一代英特尔 Movidius Myriad 视觉处理单元 (VPU),用于边缘媒体、计算机视觉和推理应用,以及难产三年终于落地的 Nervana 系列,面向训练 (NNP-T1000) 和面向推理 (NNP-I1000) 的 Nervana 神经网络处理器 (NNP)。
; S& C( g; s6 B. m三条 AI 芯片产品线的发布,标志着英特尔人工智能业务获得实质进展。
0 W! ~; b+ i) C- B6 A+ b% b ; A. V* }3 @* A/ R: v: Y5 ]) B( l
在最近的财报电话会议上,英特尔乐观地预测,2019 年人工智能的年收入达到 35 亿美元,高于 2017 年的 10 亿美元,完成 2022 年 100 亿美元目标的三分之一以上。8 D5 e: q5 y1 k% D7 J9 Z
英特尔透露,在无人机、相机、机器人和自动驾驶汽车等设备的边缘计算收入同比增长了 20%。
: c, j- c% P. e. X+ s _8 n" {「这一数字将逐年增长,基于我们的广度与深度,已经从数据中心走到边缘。」英特尔公司副总裁兼 AI 产品事业部总经理 Naveen Rao 表示。
( Z" F8 j& J! n b1
0 R# l! s9 m6 v7 }. ]8 w! M2 }边缘端性能十倍提升- t" @" u5 ^1 k1 W0 Y2 p3 D
英特尔详细介绍了代号为 Keem Bay 的下一代 Movidius Myriad 视觉处理单元(VPU),该单元针对边缘推理任务进行了优化。
& R0 P5 k. T/ R- S, \
z5 s+ [( J4 d2 H9 h% C$ E英特尔物联网副总裁乔纳森·巴伦(Jonathan Ballon)表示,该芯片拥有一种新的片上存储器架构,具有 64 位存储器带宽,性能是上一代产品的约 10 倍。7 F+ e" z$ H }% q! V* L5 u) j
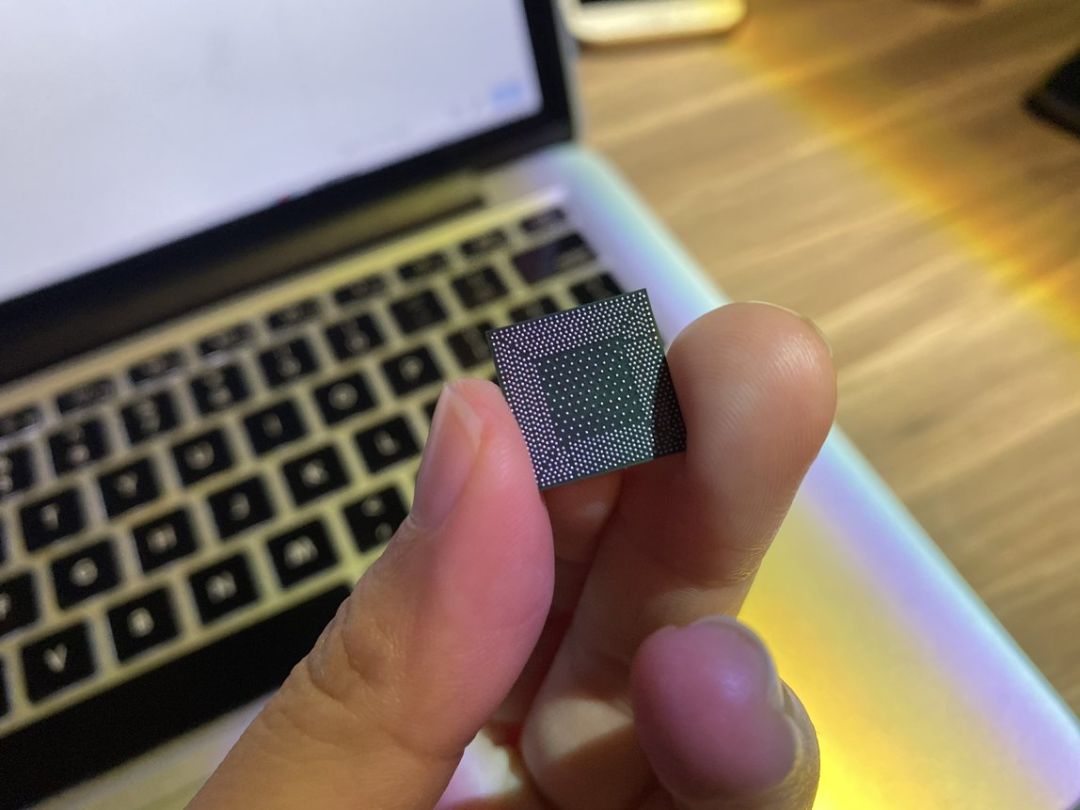 机器之心现场实拍 巴伦称:「它将以比同类产品低一倍的性能,几分之一的尺寸和成本来提供优于 GPU 的性能。」
$ a0 d1 x5 d* v: ^- [: e D; ]$ gKeem Bay 中封装了用于计算机视觉的专用芯片和 12 个可加快运行速度的专用(SHAVE)处理器内核,可使用 Myriad Development Kit(MDK)进行编程,从而兼容更多 AI 算法。
$ R ]3 [$ f+ E8 ]& ]6 i1 Y0 Q) m英特尔表示,Keem Bay 的功耗是 Nvidia 的 Jetson TX2 的四分之一,比华为昇腾(Ascend)310 计算速度快 1.25 倍。在特定情况下,能效比竞争对手的处理器高六倍,每秒提供的 TOPS 推理量是 Nvidia 的 Xavier 的四倍。
3 |) @! A5 l* V% |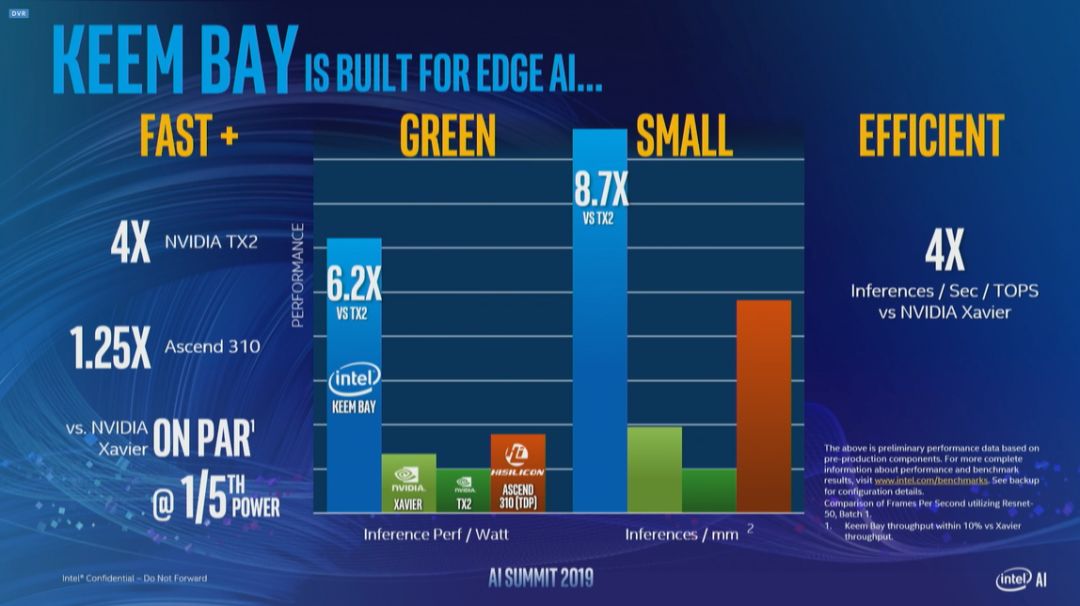
) ~' y/ G+ O2 h. [该款芯片将在 2020 年上半年推出,包括 PCI Express 和 M.2 等形式。- @- ?& J' o7 {' Q' f" d6 p" r
早在 2016 年 9 月,英特尔就收购总部位于圣马特奥的 AI 初创团队 Movidius,设计用于计算机视觉的专用低功耗处理器芯片,为其终端算力市场步下重要一子。
% F! z& N: F9 e S+ U% S2017 年,英特尔推出 Myriad 2,被 Google 的 Clips 相机,大疆的 Phantom 4 无人机,和国内安防市场的高端摄像头所采用。
$ ?9 g' H3 Y3 H2 P; O5 B, i; \2 s: _随后推出的 Myriad X 具有改进的成像和视觉引擎,包括附加的可编程 SHAVE 内核和升级的视觉加速器,以及支持多达 8 个高清传感器的本地 4K 图像处理器管线。
0 x* S3 j2 L; A参考英伟达在软件生态的深厚基础而能厚积薄发,这次巴伦也着重强调了,英特尔在软件与开发工具方面的努力,使用英特尔OpenVINO 工具包的客户可以获得大约 50%的额外性能。 C* u& |3 O# w# Y. l
基于 OpenVINO 工具包,Edge AI DevCloud 能够对无人机和摄像头等边缘设备进行 AI 原型和测试,开发人员可以使用现有工具和框架免费测试和优化 OpenVINO 中用于 Intel 硬件(例如 CPU 或 FPGA)的模型。
) ~' _. m" z; E- b随着 Edge AI DevCloud 的发布,客户现在能够使用在夏季推出的 Deep Learning Workbench 工具进行建模和仿真,然后将其免费部署在开发云中的各种不同硬件配置上。5 c- o% D# b: F7 ?, Y
Ballon 在与 VentureBeat 的一次对话中称,OpenVINO 是英特尔历史上增长最快的工具。! Y4 Y+ G( k! _# i( u, @1 q
2018 年 5 月,英特尔首次向开发人员和制造商提供 OpenVINO 或开放式视觉推理和神经网络优化,以使用英特尔硬件进行深度学习推理。
. h& Y4 ~ L0 `* _OpenVINO 支持从 CPU,GPU 和 FPGA 到 Intel Movidius 神经计算棒的一系列机器学习加速器。该工具包于今年早些时候进行了更新,以扩展到计算机视觉应用之外,并支持语音和 NLP 模型。
+ R1 I/ c% _! ?# r h+ x英特尔今天还与 Udacity 一起推出用于物联网纳米级程序的 Edge AI。据悉,正在创建的数据中有 70%位于边缘,只有一半将进入公共云,其余的将在边缘存储和处理。
6 c, `6 }3 g, C8 f3 g! ~2) q7 m. J4 [9 N3 c
云端AI芯片终商用
$ k( D: C: H0 g在终端之外,英特尔当然没忘最核心的数据中心市场,Nervana 产品线难产三年终于落地。
/ C1 T" Z3 `8 a* z' Z8 m- ~7 O& c
英特尔推出面向 AI 推理和 AI 训练领域的两个系列产品,分别是神经网络训练处理器(Intel Nervana NNP-T)和神经网络推理处理器(Intel Nervana NNP-I),作为英特尔为云端和数据中心客户提供的首个针对复杂深度学习的专用 ASIC 芯片。
7 m% E; C1 [. d, E, h6 h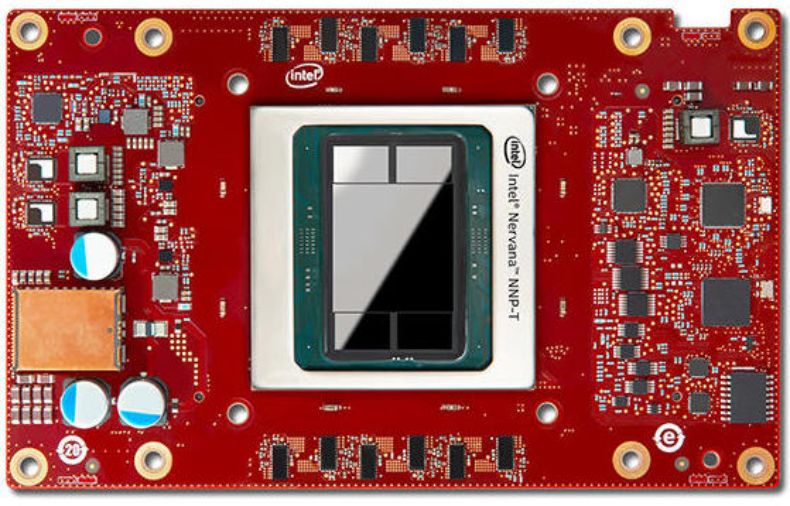 , X+ l( F( m$ W) K% s
训练芯片 NNP-T 采用台积电 16nm 制程工艺,拥有 270 亿个晶体管,硅片总面积达 680 平方毫米,支持所有主流深度学习框架。* B, C3 {' B$ L5 E& n( C
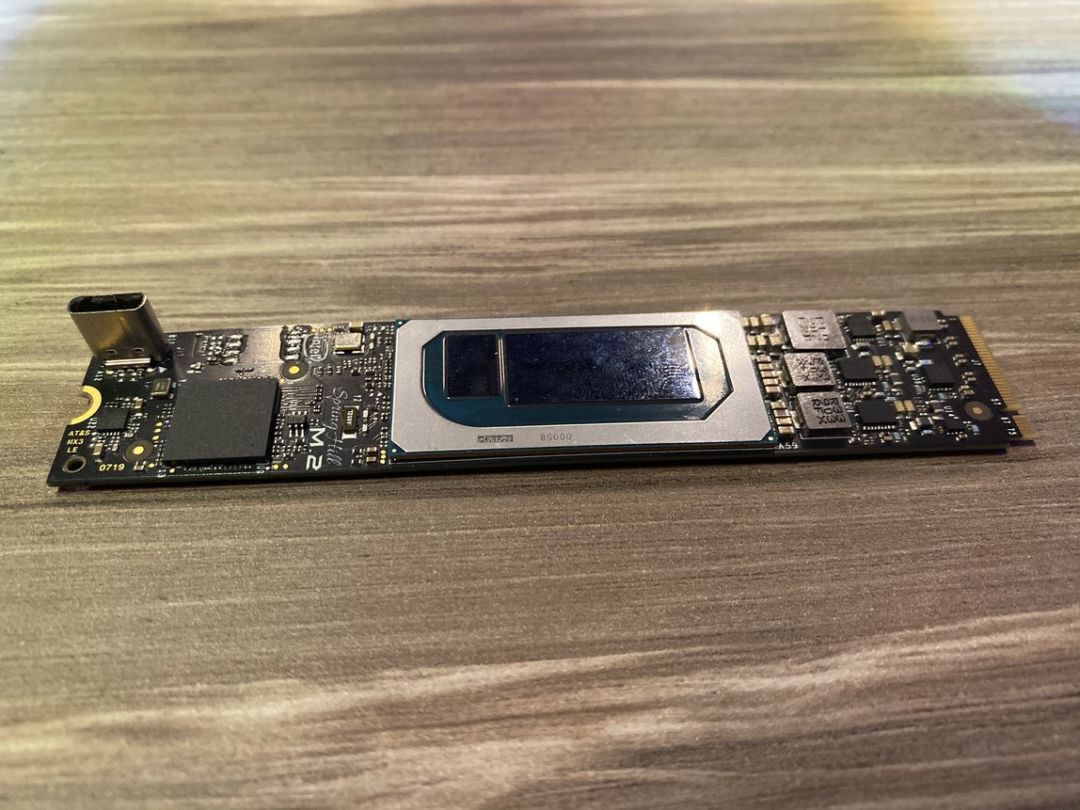 机器之心现场实拍推理芯片 NNP-I 基于英特尔 10nm Ice Lake 处理器架构,在 ResNet50 上的效率可达 4.8 TOPs/W,功率范围为 10W 到 50W 之间,同样支持所有的主流深度学习框架。早在 2016 年,英特尔就提出启动 Nervana 神经网络处理器的项目研发,直到今年才正式揭晓,并宣告正式投入生产,并实现商用。
. g, B, ]5 {9 v7 l O% ^( p值得注意的是,这两款产品面向百度、 Facebook 等前沿人工智能客户,并针对这些企业的 AI 处理需求进行定制开发。1 r( F0 p6 k5 o5 n4 O9 i
谈到英特尔Nervana的独特性和优势时,英特尔公司人工智能产品事业部副总裁、推理产品事业部总经理Gadi Singer向机器之心表示,主要集中在功效、功能、规模化三个方面。5 D4 c! D8 k- O" ~/ x7 y y, ~! o& l
* S8 z, W7 q; i. R5 D/ |6 B9 i) g, k- 1)在功效方面,Nervana提供了非常节能的构建模块(building blocks),大概能提供10到15瓦的解决方案,可以单独使用,也可以基于需求将多个模块集成。因此无论大小,都能满足用户在任何级别上构建解决方案。5 `& N$ T" }* L% d2 G, n# _
- 2)多功能性。不同于市面上的图像或语音单功能处理器,Nervana的立项之初就是必须支持多种用途。通过构建一组深度学习的功能,可以被应用多个不同类型的机器学习任务中。; ]' I7 F+ a5 v+ n3 g+ p& H6 B
因为在大型云服务应用某些内容时,需要以多种形式使用它,因此需要在广泛的范围内提供良好的解决方案。, b1 r( ]. T6 E8 U8 Z K* U3 @. S' I
深度学习变化得如此之快,AI从某个研究实验室到或公司开始注意到开发再到部署可能只需要不到一年的时间,就好比去年BERT出来时, 三个月内大家对它进行了广泛的试验,一年之内对其进行了非常大规模的部署。7 U4 N% G L$ C! D
在瞬息万变的环境下,研发出一个能随时‘准备就绪’的通用解决方案,我们才可以解决甚至还没有被广泛关注的新问题。因此,我们的架构是使用构建模块不断进行重组。
( \$ m" f$ Q6 U3 y4 u1 T - 3)最后是规模化,比起硬件方面,更多组员主攻的是软件这个部分。软件对整个解决方案的优化非常关键,比如软件能了解在不同的内存位置以及使用这些功能分别需要的时长,软件能每个数据模块的使用频率并把它们放置在正确的位置上,让你可以最高效地使用推理计算引擎。
$ h- r: C6 W; K- f' ^( QNervana架构与某些单一用途的同类产品不同,使用带有接口通道的API分层构建它。最底层的API直接与硬件打交道,然后中间会有一些类似于图谱节点的API,像是深度学习图谱中的高级计算单元,然后最高层的软件层将它们映射到用户所需要的任何应用程序接口中。
9 f1 K8 d4 Q. ], \% C' S
$ q' _- G* A; W& ?
3
: S& y! m9 I3 `% ?5 u巨头掘力终端
9 y! ? A# x% X1 [3 ^不止于英特尔,细心观察就会发现,今年巨头发力终端和边缘端的算力市场比以往声量更大。这在某种意义上也标志着终端 AI 芯片市场的成熟,巨头开始收割。3 T4 ~/ N ^: u8 ~; I3 b9 e9 H" ~
1、英伟达
' O1 X \! P9 x T+ m p. NJetson 是英伟达在面向嵌入式市场的产品线,正是对标英特尔 Movidius。区别于其他边缘 SoC 的特点,Jetson 家族强调并行运行多个神经网络。, E4 n$ l n9 n" J; g7 V! H
截至目前,Jetson 已发布四个系列,包括 Jetson TX1、Jetson TX2、Jetson Nano、Jetson Xavier NX,主要部署在边缘与终端应用上,适用于机器人、无人机和智能摄像头等应用。6 C- D/ F# G! u+ f# p& M0 D
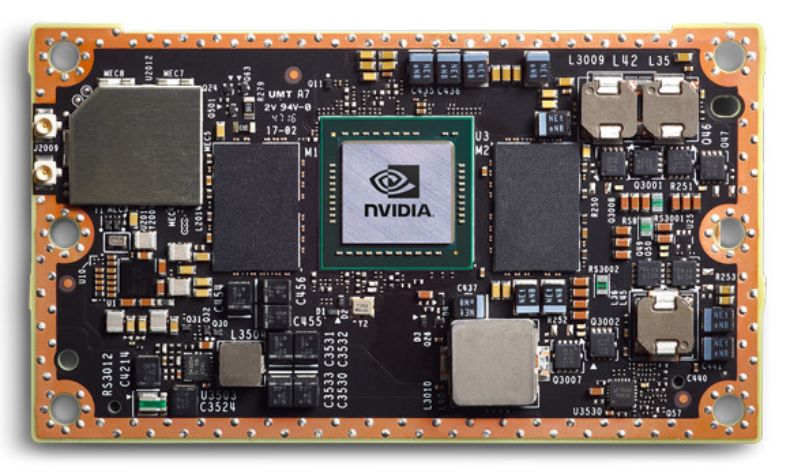
8 w/ ^* h( K0 [8 t7 M. g5 i5 ~2 B2017 年,英伟达推出首款采用 Pascal GPU 架构(16 nm 工艺)的芯片 Jetson TX2,大小相当于一张信用卡。官方给出的数据显示,TX2 可在 MAX Q、MAX P 两种状态下运行,功耗在 7.5W-5W。8 L7 ~& s' f' ]$ e/ l+ _5 I! @7 h
2018 年,英伟达发布 Jetson 系统级模块——AGX Xavier,可提供工作站级别的任务执行性能。AGX Xavier 有 10W/15W/30W 三种选择,神经网络运算输出为 32TOPS,可应付多达四路的 HEFC 4K 、60fps 视频流。+ C9 l# |. f2 T# o9 u$ \3 t
而就在上周,英伟达进一步推出 Jetson 的最新成员 Jetson Xavier NX,号称「全球最小边缘超算」。
" e$ Y7 ]1 ~4 p! [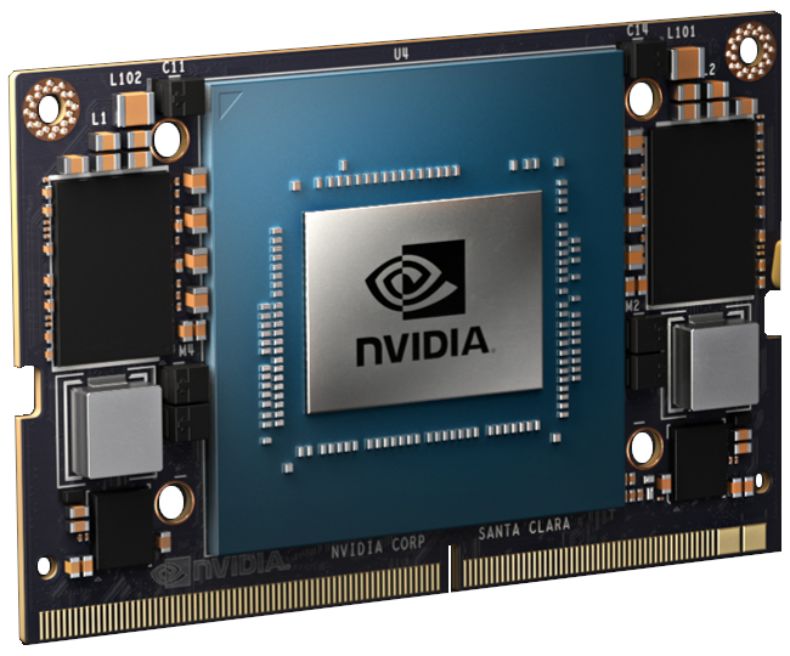 , K$ Q! B I: p
可提供高达 14 TOPS(功耗为 10W 时)或 21 TOPS(功耗为 15W 时)的性能,能够并行运行多个神经网络,并在与 Nano 同样尺寸(70x45mm)的小巧外形中同时处理来自多个高分辨率传感器的数据。
; T& v T- E( C. s! K3 D: D" oXavier NX 将于明年 3 月开始发售,价格 399 美元。/ i1 J; S. \& M2 K! Y5 P' k3 ?4 ?
与此同时,英伟达为 Jetson 配置了一套开放式平台和完整的 AI 软件堆栈 JetPack SDK,可以运行复杂的 AI 网络,并用于深度学习的加速库以及计算机视觉、计算机图形、多媒体等。! Y S7 D' M6 r1 }: Q
2、谷歌( D" ^$ B& ]! r+ g0 [9 C$ E
今年年早些时候,谷歌推出名为 Coral 的本地终端 AI 平台,是 TPU 的边缘芯片版本,强调以低功耗水平提高出色的 ML 推理性能。能够以良好的功率表现执行 MobileNet v2 等最先进的移动视觉模型,且 fps 可达 100 以上。
9 s7 } o6 i% P5 r1 t$ [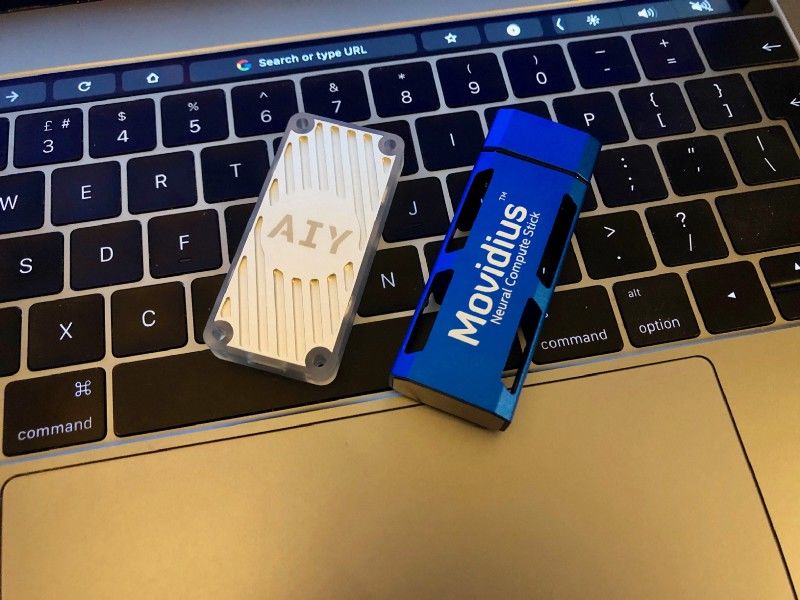 Coral USB 加速棒(图左)与第一代英特尔神经计算棒(图右)。基于 Corel 平台,谷歌发布了五款设备,分别是单板计算机「Coral Dev Board」、支持 Raspberry Pi 或 Debian Linux 计算机的 USB 加速器、对应 Dev Board 的 500 万像素镜头模块、 Dev Board 的系统模块(SoM),和轻易将机器学习加速器 Edge TPU 与现有计算机系统整合的 PCI-E 加速器。3、华为0 A* J7 _3 L/ f# i( _; O6 [5 F
看国内市场,当属华为作为风向标。
5 O3 j z- g; q; z A2 ]去年,华为发布全面自研芯片信号,昇腾则是其推出的首款面向边缘计算品牌,采用华为自有的达芬奇架构(12nm 工艺),使用华为自有的高效灵活 CISC 指令集。6 a7 b9 y& F2 h2 E
昇腾系列除了瞄准机器人、智能制造等终端智能产品,同时也是华为在安防智能摄像头和边缘计算的重要布局。
. O0 y! M0 K+ u, X8 H8 O- e% L昇腾 310 最大功耗为 8W,半精度(FP16)运算能力 8TFLOPS,整数精度(INT8)16TOPS,支持 16 通道全高清视频解码(H.264/265)。在今年上半年正式推出。7 z3 o$ x( e- X# s0 @. k
4/ o, u l( B. Y4 x' _8 C4 P0 ?
AI芯片创业压力加剧0 F8 z+ \- k6 n. q o$ v, R5 I2 }& L2 v
很长一段时间里,由于云端 AI 芯片市场被集中垄断,同时更加依赖生态,导致大部分 AI 芯片的初创公司都将目标瞄准在边缘和终端市场,以各种 AI 加速器或 SoC 芯片的形式走向市场。
s: @/ N8 W8 c0 [1 o" @8 S* w
+ p+ |' g+ a- B# J% W: R! M- M% c通过独特的架构设计以及领先的性能指标的芯片,以求在分散而潜力巨大的物联网市场分得一杯羹。, S) P# Y5 {5 B$ A( P
如今,英特尔 Myriad Keem Bay、英伟达 Jetson Xavier NX 的推出不仅标志着巨头边缘端 AI 芯片布局的完善和实力的进一步增强,同时也是边缘端芯片市场竞争更加激烈的强烈信号。0 O6 i, ~1 p* B3 n" W* A
巨头的 AI 芯片触角蔓延至边缘端,将让 AI 芯片初创公司面临着更加严峻的生存挑战。
2 s# L. n/ u; L2 J' R4 e9 ?机器之心Pro
F. b5 D" M" c" N: @- k追动态 | 查数据 | 找资源 | 读报告 | 做调研
& O) S; {2 u, j9 ]6 \2 `6 q ~* t3 w8 F% n3 s5 h! H
, r3 O7 o! L _% v机器之心Pro 是基于「机器之心团队构建的百万级规模人工智能知识图谱及结构化数据库」搭建的人工智能领域专业信息平台。* x* e+ E( z( d) |" C
# P8 Y8 v+ X$ r$ s" m% w$ q3 ]9 h0 x1 x# Z3 o- C
目前已上线五个模块:dashboard、新闻数据库、行业数据库、人工智能知识库和深度精选,覆盖 38 个技术领域及 55 个智能应用领域。( g$ ^8 Z+ P5 Q/ h: B
$ j0 \; r9 E( N F m/ a7 l0 V
) @. a" z8 k2 W' M6 [
 9 a" i: k% f( } c+ b3 b
点击图片,查看官方使用手册
* g# q+ F, h* q6 W8 ~4 \
/ l- o# q% {- b& E; e+ X1 \2 Q; q- X& }
$ \7 f. H: y. e6 e: I/ i& x) n9 F o$ V% |0 I
% [' m" P8 _6 i/ ~. K7 ~
pro.jiqizhixin.com# P* K8 \) O; P5 ^
盯动态、找资源、做调研
! a9 R/ u# U1 G: w9 G3 D5 V, W' |( z9 x4 ?3 P# J& p
* @; Q h$ c9 j# X% R2 f3 r: }
) q' e% ~1 B5 T9 T/ s" j% I3 U* B来源:http://mp.weixin.qq.com/s?src=11×tamp=1573628405&ver=1971&signature=T5-sAwq-3m5Q2XlXSyEJnWUzh*XzLRqDFNvi*WAAS8uu4I4H4Re6QNqwZbiN4Ovbj*Y3-E5GkoZ3ZrDQ3TQtQV6Be2aXF9hTw59p6X72-r5hzKx5ru-uIEq9FLCRlQ4t&new=16 e% o- v+ d3 f) T9 e9 }' e R
免责声明:如果侵犯了您的权益,请联系站长,我们会及时删除侵权内容,谢谢合作! |
 |手机版|小黑屋|梦想之都-俊月星空
( 粤ICP备18056059号 )|网站地图


 发表于 2019-11-13 15:35:28

