乾明 鱼羊 栗子 发自 凹非寺
% I1 Y8 X9 p4 ]9 [5 T+ l$ ]量子位 报道 | 公众号 QbitAI
( L4 V+ D+ P0 ]8 P6 ^! Y! I+ X6 |6 D# Y, H
仅剩0.2%的星际2玩家,还没有被AI碾压。' }6 x4 Y9 O, a% {( b
8 U* d1 S" L0 t7 A+ |
这是匿名混入天梯的AlphaStar ,交出的最新成绩单。
3 R, O% z4 x: ?0 }. Y同时,DeepMind也在 Nature上 完整披露了AlphaStar的当前战力和全套技术:
AlphaStar ,已经超越了99.8%的人类玩家,在神族、人族和虫族三个种族上都达到了宗师(Grandmaster)级别。
" z. j" u# g- J# H
# O0 u' D# f' y: @4 P) T- s3 ^5 [$ H5 R7 D3 Y5 Z
在论文里,我们还发现了特别的训练姿势:
$ C" p$ V- `& \不是所有智能体都为了赢! J7 ~! v9 A3 U7 V& A
* a) e$ v9 \* `. n; @# Q0 iDeepMind在博客里说,发表在Nature上的AlphaStar有四大主要更新: ( f; u3 ] x) `" P1 f: u9 \, S: o
一是约束:现在AI视角和人类一样,动作频率的限制也更严了。* ?9 t6 \& g8 M) j5 ]+ P c+ a
二是人族神族虫族都能1v1了,每个种族都是一个自己的神经网络。 L) u* E/ S g }3 L$ ?# Z3 R$ ~
三是联赛训练完全是自动的,是从监督学习的智能体开始训练的,不是从已经强化学习过的智能体开始的。
+ @3 B. n. d" {. E四是战网成绩,AlphaStar在三个种族中都达到了宗师水平,用的是和人类选手一样的地图,所有比赛都有回放可看。
; a e5 W8 R' H/ q5 h 具体到AI的学习过程,DeepMind强调了特别的训练目标设定:
- V. J' ~5 K; O; ]+ ]1 ?8 a3 a1 J不是每个智能体都追求赢面的最大化。 : |! T# R% w/ z' A
6 T5 x% W0 b7 k1 i因为那样智能体在自我对战 (Self-Play) 过程中,很容易陷入某种特定的策略,只在特定的情况下有效,那面对复杂的游戏环境时,表现就会不稳定了。
N) Z! [, C( a6 N: p5 l于是,团队参考了人类选手的训练方法,就是和其他玩家一起做针对性训练:一只智能体可以通过自身的操作,把另一只智能体的缺陷暴露出来,这样便能帮对方练出某些想要的技能。 . l$ I J$ B. ~* ` X
这样便有了目标不同的智能体:第一种是主要智能体,目标就是赢,第二种负责挖掘主要智能体的不足,帮它们变得更强,而不专注于提升自己的赢率。DeepMind把第二种称作“剥削者 (Exploiter) ”,我们索性叫它“陪练”。 3 a& r3 m: [* w
AlphaStar学到的各种复杂策略,都是在这样的过程中修炼得来的。
: x2 s# g' }* V! J3 M5 Z- g3 c比如,蓝色是主要玩家,负责赢,红色是帮它成长的陪练。小红发现了一种cannon rush技能,小蓝没能抵挡住: . Y" e! J' s/ u2 X
! N+ m F; `# C8 q* w+ O然后,一只新的主要玩家 (小绿) 就学到了,怎样才能成功抵御小红的cannon rush技能: z, W$ v5 K3 l5 W
( w: ^% u: r$ S, r" P. b
/ ^+ U T* _# e# q) j. x& W
同时,小绿也能打败之前的主要玩家小蓝了,是通过经济优势,以及单位组合与控制来达成的:
; z+ Y3 g% R* p3 }/ G$ ^ 7 E7 |" R( A, j( b6 U* G) p
& g( a6 j# d0 _: C( \7 K
后面,又来了另一只新的陪练 (小棕) ,找到了主要玩家小绿的新弱点,用隐刀打败了它:
9 ?. R! r N, S, X+ m, V0 f ( w. _" f" L5 j( W4 w) r" l5 |
( g* c% O2 y9 w8 A循环往复,AlphaStar变得越来越强大。
- J' Q' n+ o- P6 h! n" V j* m( X 3 q, q2 [% J6 J& o5 V5 n
至于算法细节,这次也完整展现了出来。 . u" y! k1 ^6 r9 ~0 c6 i
AlphaStar技术,最完整披露$ I! A8 E3 F. g7 F. Z- s
" B2 j9 D1 R7 ?9 e$ C+ {5 t' b$ U许多现实生活中的AI应用,都涉及到多个智能体在复杂环境中的相互竞争和协调合作。
: y; O( ~1 Z/ F Y而针对星际争霸这样的即时战略(RTS)游戏的研究,就是解决这个大问题过程中的一个小目标。 $ Y# e0 A' ~# n* M6 E1 F+ w- j7 a
也就是说,星际争霸的挑战,实际上就是一种多智能体强化学习算法的挑战。
2 @0 s* v& h5 f2 Y# JAlphaStar学会打星际,还是靠深度神经网络,这个网络从原始游戏界面接收数据 (输入) ,然后输出一系列指令,组成游戏中的某一个动作。
. R h) T1 q* Z% @% X
6 M0 w0 ?" u( d; m+ @% B7 HAlphaStar会通过概览地图和单位列表观察游戏。
+ e) o5 @0 M% t5 Z$ ?: S采取行动前,智能体会输出要发出的行动类型(例如,建造),将该动作应用于谁,目标是什么,以及何时发出下一个行动。 / s' x+ C @8 ^( Z( q* W( S
动作会通过限制动作速率的监视层发送到游戏中。
5 B! B+ `( w$ X, e
. f x/ D4 Y# ^, a% U而训练,则是通过监督学习和强化学习来完成的。 3 G9 x; P' w( I% V; K# x, R, Q* \
最开始,训练用的是监督学习,素材来自暴雪发布的匿名人类玩家的游戏实况。
9 P$ Q9 y* R/ ?2 m. T* P; `% |" y {0 }这些资料可以让AlphaStar通过模仿星际天梯选手的操作,来学习游戏的宏观和微观策略。 6 M# g* }* G9 G% C M6 `" P8 I
最初的智能体,游戏内置的精英级 (Elite) AI就能击败,相当于人类的黄金段位 (95%) 。
+ c# k0 P, o G+ o而这个早期的智能体,就是强化学习的种子。 + N( I J( h- @0 a" {
在它的基础之上,一个连续联赛 (Continuous League) 被创建出来,相当于为智能体准备了一个竞技场,里面的智能体互为竞争对手,就好像人类在天梯上互相较量一样: ) s& o, f7 c# i
从现有的智能体上造出新的分支,就会有越来越多的选手不断加入比赛。新的智能体再从与对手的竞争中学习。 , l3 J6 E* D& L: S* ?
这种新的训练形式,是把从前基于种群 (Population-Based) 的强化学习思路又深化了一些,制造出一种可以对巨大的策略空间进行持续探索的过程。 ' Z `3 M/ T% S+ f, Q* y
这个方法,在保证智能体在策略强大的对手面前表现优秀的同时,也不忘怎样应对不那么强大的早期对手。
* a/ e, Z6 m3 g) G随着智能体联赛不断进行,新智能体的出生,就会出现新的反击策略 (Counter Strategies) ,来应对早期的游戏策略。
s/ x4 b( c; r" K/ K+ m一部分新智能体执行的策略,只是早期策略稍稍改进后的版本;而另一部分智能体,可以探索出全新的策略,完全不同的建造顺序,完全不同的单位组合,完全不同的微观微操方法。 / R/ R( s! n7 ?
除此之外,要鼓励联赛中智能体的多样性,所以每个智能体都有不同的学习目标:比如一个智能体的目标应该设定成打击哪些对手,比如该用哪些内部动机来影响一个智能体的偏好。 5 A! H: ^7 g, n1 F. j2 B. m
2 l O7 J. l0 E: Q" ~$ u- z$ X5 T! h7 h: K, Q/ n" q/ k& C
而且,智能体的学习目标会适应环境不断改变。! e* H% T# @7 f* _. s6 p
, E9 Y6 d& Z# {3 p8 E1 q/ T) O j$ G
神经网络给每一个智能体的权重,也是随着强化学习过程不断变化的。而不断变化的权重,就是学习目标演化的依据。 ' X0 j+ W; z" Y6 N
权重更新的规则,是一个新的off-policy强化学习算法,里面包含了经验重播 (Experience Replay) ,自我模仿学习 (Self-Imitation Learning) 以及策略蒸馏 (Policy Distillation) 等等机制。
0 L% i4 h* E, m4 p历时15年,AI制霸星际# e7 D( n- E/ g$ Z1 P5 _7 O
" c$ y) P% M/ s/ M# Y* [《星际争霸》作为最有挑战的即时战略(RTS)游戏之一,游戏中不仅需要协调短期和长期目标,还要应对意外情况,很早就成为了AI研究的“试金石”。 / p3 L$ ]6 g6 k- }6 o
因为其面临的是不完美信息博弈局面,挑战难度巨大,研究人员需要花费大量的时间,去克服其中的问题。
/ q; [4 {& K1 _- K3 ODeepMind在Twitter中表示,AlphaStar能够取得当前的成绩,研究人员已经在《星际争霸》系列游戏上工作了15年。
0 j2 R7 J4 Y$ ~5 I2 [0 x
& \8 b! y/ ?6 C0 {3 r5 L但DeepMind的工作真正为人所知,也就是这两年的事情。 9 w/ M( {" E% }& H
2017年,AlphaGo打败李世石的第二年后,DeepMind与暴雪合作发布了一套名为PySC2的开源工具,在此基础上,结合工程和算法突破,进一步加速对星际游戏的研究。
- s4 R; u2 a$ w) }$ \) ^ n之后,也有不少学者围绕星际争霸进行了不少研究。比如南京大学的俞扬团队、腾讯AI Lab、加州大学伯克利分校等等。
7 }, M$ `/ E: r% a7 n6 c( R% O到今年1月,AlphaStar迎来了AlphaGo时刻。 . ~8 X; i5 R/ Q6 }
在与星际2职业选手的比赛中,AlphaStar以总比分10-1的成绩制霸全场,人类职业选手LiquidMaNa只在它面前坚持了5分36秒,就GG了。
. N! t/ f; [% y3 x" a
: F* {: L% ^' |0 h全能职业选手TLO在落败后感叹,和AlphaStar比赛很难,不像和人在打,有种手足无措的感觉。
/ }7 R# k" h0 h+ B4 R# b$ A8 E半年后,AlphaStar再度迎来进化。 6 \% i# D( f4 p: v/ D& V; S
DeepMind将其APM (手速) 、视野都跟人类玩家保持一致的情况下,实现了对神族、人族、虫族完全驾驭,还解锁了许多地图。 " R6 y# L4 f+ `% o. V
6 p$ o% _6 `8 T* b与此同时,并宣布了一个最新动态:AlphaStar将登录游戏平台战网,匿名进行天梯匹配。
+ ]0 Z$ F4 \( y( T( D, E现在,伴随着最新论文发布,AlphaStar的最新战力也得到公布:击败了99.8%的选手,达到宗师级别。
' t1 [! s% ?4 c( j* sDeepMind在博客中表示,这些结果提供了强有力的证据,证明了通用学习技术可以扩展人工智能系统,使之在复杂动态的、涉及多个参与者的环境中工作。
& L9 H; S2 t8 k: L( u而伴随着星际2取得如此亮眼的成绩,DeepMind也开始将目光投向更加复杂的任务上了。
# e+ m8 e. o6 V9 j/ NCEO哈萨比斯说:
+ M- @% ~5 u4 @2 D! v星际争霸15年来一直是AI研究人员面临的巨大挑战,因此看到这项工作被《自然》杂志认可是非常令人兴奋的。" t5 W$ m0 ]1 n0 h
这些令人印象深刻的成果,标志着我们朝目标——创造可加速科学发现的智能系统——迈出了重要的一步。
4 ^- I% ]+ F' \. o2 N; L 那么,DeepMind下一步要做什么?
: R- M. F6 k' H* K) T- u/ f哈萨比斯也多次说过,星际争霸“只是”一个非常复杂的游戏,但他对AlphaStar背后的技术更感兴趣。
# f& y2 m4 P8 `- a3 g6 j! m' B7 {但也有人认为,这一技术非常适合应用到军事用途中。 - U$ e2 _) G8 K' r
不过,从谷歌与DeepMind 的态度中,这一技术更多的会聚焦在科学研究上。 6 y/ p5 q$ m3 `+ y4 A" ?
其中包含的超长序列的预测,比如天气预测、气候建模。 ' l. m5 ]% S% G* G$ _: z
或许对于这样的方向,最近你不会陌生。
6 K2 f( x& g$ x因为谷歌刚刚实现的量子优越性,应用方向最具潜力的也是气候等大问题。
! {2 R. y; G1 h( R现在量子计算大突破,DeepMind AI更进一步。 8 `6 c2 j6 ?( Q" h
未来更值得期待。你说呢? % K7 [1 p/ g5 i4 D& U
One more thing! W% z. g; G& Q. b9 k
) s2 a8 b [" N2 Y# S" l, r
虽然AlphaStar战绩斐然,但有些人它还打不赢。
% m K9 ]* e: ~& u: i' r) Y5 h当时AlphaStar 刚进天梯的时候,人类大魔王Serral就公开嘲讽,它就是来搞笑的。 ) y5 G1 o- e8 ]' E! k( G& Z
) s0 U. \: ?- G9 j0 {
但人家的确有实力,现在依旧能正面刚AI。
! M- G; k* W8 e5 W# \不过,敢这样说话的高手,全球就只有一个。 ' {! |" l' {5 y0 z
传送门 R5 X( m) a7 J% E; _8 b
9 r' {' V' H1 l$ U6 O: p
Nature论文:
4 }# _5 N# y B/ phttps://doi.org/10.1038/s41586-019-1724-z - P" s1 {1 k( P k
论文预印版:
4 }1 R8 L* M' D: x: C2 hhttps://storage.googleapis.com/deepmind-media/research/alphastar/AlphaStar_unformatted.pdf
3 W) d7 Q, @! ?( t3 C博客文章:
& U( V; m4 D3 Q$ d4 \3 Uhttps://deepmind.com/blog/article/AlphaStar-Grandmaster-level-in-StarCraft-II-using-multi-agent-reinforcement-learning ! s- [7 r8 O8 Z
对战录像:
/ y# }" J1 s8 S( s, C8 B2 Ihttps://deepmind.com/research/open-source/alphastar-resources 0 G A' [) J. E. d6 L) ?. O8 ]
— 完 —3 M0 @- p. Q$ C w9 S
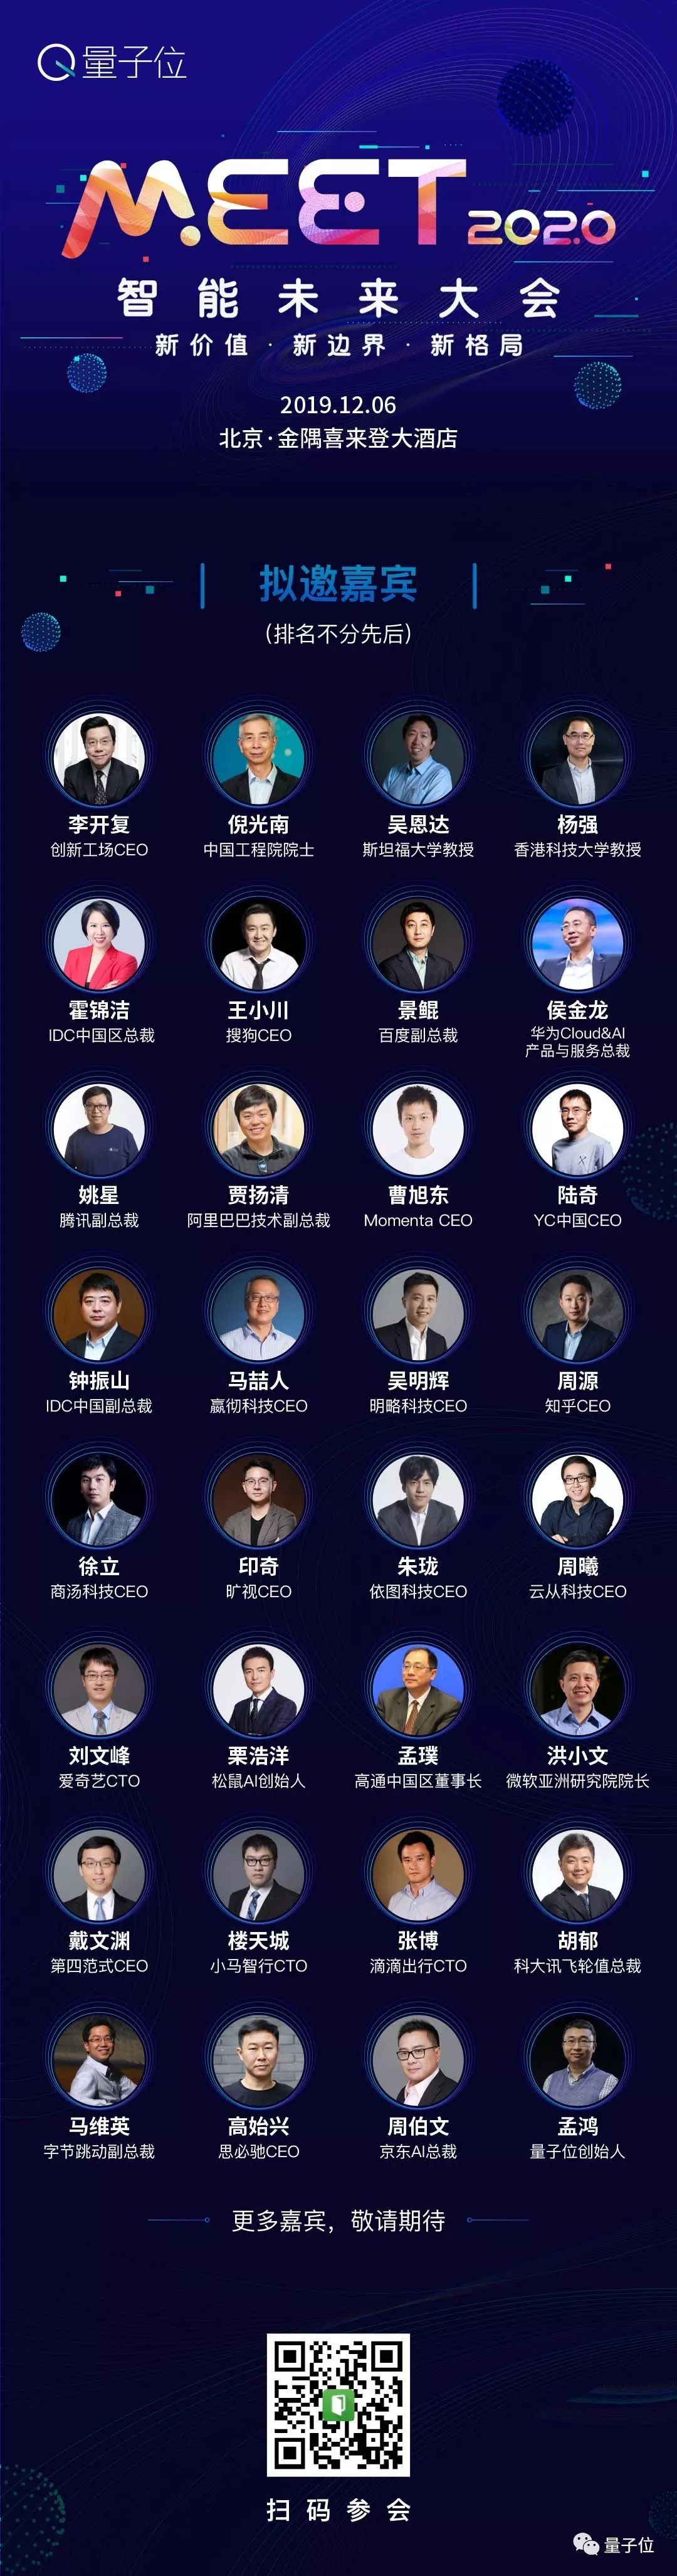
大咖齐聚!量子位MEET大会报名开启, x2 e- |5 [: w' k
量子位 MEET 2020 智能未来大会启幕,将携手优秀AI企业、杰出科研人员呈现一场高质量行业峰会!VIP票即将售罄,快扫码报名吧~! H- ]) M d$ F0 E, c, j6 N$ S
 榜单征集!三大奖项,锁定AI Top玩家
- ?/ g2 j2 y$ a4 `) W) [2019中国人工智能年度评选启幕,将评选领航企业、商业突破人物、最具创新力产品3大奖项,并于MEET 2020大会揭榜,欢迎优秀的AI公司扫码报名!
6 Y2 p4 q3 N$ n& R  量子位 QbitAI · 头条号签约作者3 I6 {7 @& x$ @5 U+ G$ w3 j- E/ d
վ'ᴗ' ի 追踪AI技术和产品新动态& ?$ W: u, n$ f! ?/ _, W
喜欢就点「在看」吧 !
# X2 G$ n! r- g" v C$ A& m/ |4 Y% b( R2 s4 Z2 [1 a3 l# Z
5 Q G% N! ?9 w: f, L6 Y# S# |
9 T* C! T7 W+ v- f7 R5 {8 N6 ^
$ Z! t) l. G- X: x% ]
- n+ R& x5 m) k: {: C2 G5 P
来源:http://mp.weixin.qq.com/s?src=11×tamp=1572508805&ver=1945&signature=ufDgJF-ttdwWgSRz4GvsbfZFt8aLHUpcC9yHtzomlOL0gOuaJsxc735aQnmgAG4n173vkU87wL1VAWURHlPQMQpVqYLRqYVHonQrB2VYxo0tKwIa7RrwLt4ddob2CbZI&new=1% {7 }* s# R7 I& G9 I9 A
免责声明:如果侵犯了您的权益,请联系站长,我们会及时删除侵权内容,谢谢合作! |  |手机版|小黑屋|梦想之都-俊月星空
( 粤ICP备18056059号 )|网站地图


 发表于 2019-10-31 16:23:08

